이 연재는 PeekCart를 네 단계로 진행했습니다. Phase 1은 단일 Spring Boot 모놀리스로 도메인을 구현한 단계, Phase 2는 캐시, 분산 락, Kafka와 Outbox로 성능과 정합성을 보강한 단계, Phase 3은 CI, Kubernetes, 관측성, 부하 테스트로 운영 환경을 검증한 단계, Phase 4는 서비스별로 나눈 MSA 단계입니다.
문제는 단순합니다. @Scheduled 는 각 JVM 프로세스 안에서 타이머를 돌립니다. Pod 이 하나일 땐 타이머도 하나라 아무 문제가 없습니다. 그런데 Phase 3에서 HPA 가 Pod 을 1에서 3으로 늘리면(k8s/overlays/gke/hpa.yml), 똑같은 @Scheduled 메서드가 세 Pod에서 각자의 타이머로 동시에 깨어납니다. 60초마다 한 번 돌아야 할 주문 취소가 세 번 돌고 5초마다 한 번이어야 할 Outbox 폴링이 세 번 실행됩니다. “한 번만 일어나야 하는 일”이 인스턴스 수만큼 중복됩니다.
ShedLock 은 이걸 DB 테이블 한 개와 락 레코드 한 행으로 풉니다. “여러 주체가 한 자원에 동시에 손대지 못하게 한다”는 발상은 분산 락 글과 같습니다. 다만 락을 거는 대상은 재고 같은 도메인 자원에서 주기 작업 그 자체로, 락 제공자는 *Redis(Redisson)*에서 **DB(JDBC)**로 바뀝니다. 왜 같은 프로젝트가 한쪽은 Redis 락, 한쪽은 DB 락을 쓰는지도 이 글에서 짚습니다.
이 글에서 쓰는 용어의 뜻은 다음과 같습니다.
| 용어 | 이 글에서의 의미 |
|---|---|
| Pod / replica | Kubernetes의 애플리케이션 실행 단위. 이 글에서는 PeekCart jar를 돌리는 JVM 프로세스 하나에 해당하고, 같은 앱을 여러 개 띄운 복제본이 replica다(문제 상황 절) |
| HPA (Horizontal Pod Autoscaler) | 부하를 보고 Pod 수를 자동으로 늘렸다 줄였다 하는 Kubernetes 컨트롤러(문제 상황 절) |
| 스케줄러 중복 실행 | 같은 @Scheduled 메서드가 여러 Pod에서 동시에 깨어나 같은 주기 작업을 N번 수행하는 현상 |
| ShedLock | 분산 환경에서 “스케줄된 작업을 동시에 한 노드에서만” 실행시키는 라이브러리. 공유 저장소(여기선 MySQL)에 락 레코드를 두고 경쟁 |
@SchedulerLock | ShedLock이 가로채는 메서드 애너테이션. name(락 식별자), lockAtMostFor, lockAtLeastFor를 받는다 |
lockAtMostFor | 락의 최대 보유 시간. 락을 잡을 때 lock_until = now + lockAtMostFor로 기록된다(5절) |
lockAtLeastFor | 락의 최소 보유 시간. 작업이 아무리 빨리 끝나도 이 시간 전에는 락을 놓지 않는다(5절) |
usingDbTime() | 락 만료를 비교할 때 DB 서버 시계를 기준으로 삼는 설정(2절) |
shedlock 테이블 | 락 상태를 담는 테이블. name이 PK라 락 이름 하나당 행 하나. lock_until, locked_at, locked_by 컬럼 |
| 상호 배제(mutual exclusion) | ShedLock이 보장하는 것. “같은 시점에 최대 한 노드에서만 실행”. “주기당 정확히 한 번”이나 “반드시 한 번”(at-least-once)은 보장하지 않는다(선택한 설계 절) |
이번 학습에서는 다음 질문을 확인하려고 합니다.
@Scheduled는 어느 범위에서 실행될까? Pod 이 늘면 왜 그대로 N배가 될까?- 스케줄러 중복 실행이 PeekCart 의 두 작업(주문 취소 / Outbox 폴링)에서 각각 무엇을 깨뜨릴까?
- ShedLock 은 DB 행 하나로 “지금 누가 돌고 있다”를 어떻게 표현할까?
@SchedulerLock을 붙이면 정확히 무슨 SQL 이 실행될까? - 재고에 쓰는 Redis 분산 락이 이미 있는데 왜 스케줄러 락은 DB로 갔을까?
usingDbTime()은 왜 분산 환경에서 사실상 필수일까?lockAtMostFor와lockAtLeastFor는 각각 어떤 실패를 막을까? 왜 둘 다 필요할까?- Phase 2는 단일 인스턴스인데 왜 그때 ShedLock 을 미리 적용했을까? 그게 정말 이득일까?
- 통합 테스트는 “여러 Pod 중 하나만 돈다”를 정말 증명했을까?
문제 상황: @Scheduled는 프로세스마다 돈다
@Scheduled 가 어디에서 실행되는지 먼저 정확히 확인하겠습니다. 이 애너테이션은 Spring 이 각 애플리케이션 컨텍스트 안에 띄우는 TaskScheduler(스레드 풀)에 타이머를 등록합니다. 즉 JVM 프로세스 하나에 타이머 하나입니다. 클러스터를 알지 못하고 다른 Pod 의 존재도 모릅니다. 그래서 같은 jar 를 세 Pod 에 띄우면, 세 개의 독립된 TaskScheduler 가 각자 60초, 5초 타이머를 돌립니다. 조율자는 어디에도 없습니다.
여기서 Pod이 무엇인지 한 줄로 짚어두겠습니다(자세한 건 이어지는 CI와 Kustomize 글). Kubernetes 에서 Pod 은 애플리케이션의 실행 단위입니다. PeekCart 맥락에선 **“우리 jar를 돌리는 컨테이너 하나 = JVM 프로세스 하나”**라고 보면 됩니다. 같은 앱을 여러 Pod으로 띄우는 걸 **replica(복제본)**라 하고 그 수가 곧 “지금 몇 개의 JVM이 같은 코드를 동시에 돌리고 있나”입니다. 앞 문단의 “JVM 프로세스 하나에 타이머 하나”를 여기 겹치면 Pod이 N개면 같은 @Scheduled 타이머도 N개라는 결론이 바로 나옵니다.
Pod 이 하나인 Phase 2까지는 이게 정확히 의도대로입니다. replica 가 1이라 타이머도 하나입니다. 문제는 Phase 3에서 **HPA(Horizontal Pod Autoscaler)**가 들어오면서 생깁니다. HPA 는 Kubernetes 가 부하(여기선 CPU 사용률)를 보고 Pod 수를 자동으로 늘렸다 줄였다 하는 컨트롤러입니다. “트래픽이 몰리면 인스턴스를 더 띄워 분산 처리한다”는, 대용량을 다루는 서비스라면 당연히 켜는 기능입니다.
# k8s/overlays/gke/hpa.yml
spec:
  minReplicas: 1          # 평소 최소 1개
  maxReplicas: 3          # 부하 시 최대 3개까지
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 60   # Pod 평균 CPU가 60%를 넘으면 증설
즉 평상시 1개로 돌다가, Pod 평균 CPU 가 60%를 넘으면 Kubernetes 가 알아서 Pod 을 최대 3개까지 늘립니다(부하가 가라앉으면 다시 줄입니다). 부하 테스트(동시 주문 부하 테스트 글)에서 실제로 이 설정으로 1에서 3으로 scale-out 이 확인됐습니다. 그런데 HPA 는 요청 처리량을 분산하려고 Pod 을 늘리는 것이지, “백그라운드 스케줄러는 하나만 돌려야 한다”는 사정은 전혀 모릅니다. HPA 에게 Pod 은 다 똑같은 복제본이고 복제본은 코드 전체를 복제하므로 @Scheduled 도 함께 복제됩니다. 그래서 처리량을 위해 Pod 을 늘린 부수효과로, 의도치 않게 스케줄러까지 3중으로 돌게 됩니다. Pod 이 3개가 되는 순간 두 스케줄러는 이렇게 됩니다.
flowchart TD
    subgraph Pod1["Pod 1"]
        S1["@Scheduled<br/>cancelExpiredOrders()"]
    end
    subgraph Pod2["Pod 2"]
        S2["@Scheduled<br/>cancelExpiredOrders()"]
    end
    subgraph Pod3["Pod 3"]
        S3["@Scheduled<br/>cancelExpiredOrders()"]
    end
    S1 --> DB[("같은 MySQL")]
    S2 --> DB
    S3 --> DB
세 Pod 이 거의 동시에 깨어나 같은 만료 주문 목록을 조회하고 각자 취소, 재고 복구를 시도합니다. 두 작업에서 구체적으로 무엇이 깨지는지 보겠습니다.
(1) 결제 타임아웃 스케줄러: 막는 주체는 ORD-002가 아니다
세 Pod 이 같은 만료 주문 #42 를 조회하고 셋 다 cancelExpiredOrder(42) 를 부릅니다. 각 호출은 @Transactional(REQUIRES_NEW) 라 건별 독립 트랜잭션이고 안에서 다음 순서로 처리합니다(OrderCommandService).
order.cancel() → 재고 복구(restoreStock 루프) → order.cancelled 이벤트 발행직관적으로는 “첫 Pod이 취소하면 나머지는 ORD-002(이미 취소됨)로 막히겠지”라고 생각하기 쉽습니다. 하지만 그렇지 않다. Order 엔티티에는 @Version도 행 잠금도 없습니다(Order.java). 그래서 두 가지 경합이 다르게 갈립니다.
- 시차 경합: Pod A가 커밋을 끝낸 뒤 Pod B가 읽는 경우. B는 이미
CANCELLED인#42를 보고cancel()에서ORD-002를 맞습니다. 여기서만ORD-002가 발생합니다. - 동시 경합: 두 Pod 이 둘 다 커밋 전에 읽는 경우. 둘 다 상태가
PAYMENT_REQUESTED라 둘 다cancel()가드를 통과한다.@Version이 없으니 충돌도 감지되지 않습니다. 즉 진짜 동시 경합에서ORD-002는 아무것도 막지 못합니다.
그럼 동시 경합에서 정합성을 지키는 건 무엇일까? Inventory의 @Version이다(Inventory.java). 두 트랜잭션이 같은 재고를 복구하려 하면 하나만 커밋되고 나머지는 OptimisticLockingFailureException 을 맞습니다. 그러면 REQUIRES_NEW 트랜잭션 전체가 롤백되어 그 안의 order.cancel() 과 Outbox INSERT까지 함께 되돌아갑니다. 이 예외는 cancelSafely 의 catch (Exception) 가 에러 로그로 흡수합니다(결제 타임아웃 스케줄러 글). 분산 락 글에서 본 “낙관적 락이 최후 방어선” 구도가 여기서 다시 작동합니다.
그런데 이 방어는 불필요한 처리도 남고 조건도 따릅니다.
cancel()의 도메인 가드는 이 경합을 막지 못하고, 엉뚱하게도 재고 엔티티의 낙관적 락이 막습니다. 그래서 “모든 주문에 재고 항목이 있다”는 전제와 격리 수준(InnoDB 기본REPEATABLE READ)에 기댑니다.ORD-002스킵처럼 조용히 넘어가는 게 아니라 예외, 롤백, 에러 로그를 동반합니다.
그래서 ShedLock은 부하 최적화이면서 현재 구현의 정합성 방어선이기도 하다. Order 자체에 동시성 제어가 없는 상태에서, 경합이 2차 방어선(재고 @Version)까지 내려가기 전에 1차에서 끊어주기 때문입니다.
부수적인 비용도 있습니다. ShedLock 이 없으면 세 Pod이 같은 조회(findByStatusAndOrderedAtBefore)를 1분마다 반복합니다. 이 조회는 idx_orders_status_ordered_at (status, ordered_at) 인덱스를 타는 범위 조회라 풀스캔은 아니지만 동일 범위 조회가 인스턴스 수만큼 중복되며 헛돌고 롤백, 로그를 남깁니다.
(2) Outbox 폴링 스케줄러: 중복 발행으로 이어진다
이쪽은 더 직접적입니다. 세 Pod 이 5초마다 findPendingEvents(100) 로 같은 PENDING 이벤트를 조회하고 각자 kafkaTemplate.send() 로 발행합니다. 결과적으로 같은 event_id 가 토픽에 세 번 들어갑니다.
물론 이 중복은 Consumer 멱등성 글의 processed_events가 받아내도록 설계돼 있습니다. at-least-once 는 어차피 중복을 전제하니까. 하지만 “받아낼 수 있다”와 “일부러 3배로 만든다”는 다릅니다. 발행량이 인스턴스 수만큼 부풀고 Kafka, Consumer, processed_events UK 충돌 처리에 불필요한 부하가 걸립니다. 게다가 Outbox 행을 PUBLISHED 로 바꾸는 UPDATE까지 세 Pod 이 경합합니다.
정리하면 스케줄러 중복 실행이 나도, 하위 방어선(재고 @Version, Consumer 멱등성)이 받쳐주는 한 최종 정합성은 지켜집니다. 하지만 그 방어는 Order 처럼 동시성 제어가 없는 곳에서는 조건부(재고 항목 존재, 격리 수준)이고 깔끔하지도 않습니다. 게다가 “한 번이면 될 일을 N번” 하면서 불필요한 부하, 로그 소음, 발행 증폭을 만듭니다.
이건 분산 락 글의 “1차 방어선은 충돌을 예방하고, 2차 방어선은 최후에 막는다”는 구도와 똑같습니다. ShedLock이 1차 방어선(중복 자체를 안 만듭니다)이고 재고 @Version, Consumer 멱등성이 2차 방어선(만들어져도 흡수합니다)입니다. 그리고 1차가 빠지면, 정합성은 통째로 2차의 조건에 의존하게 됩니다.
선택한 설계: “지금 누가 돌고 있다”를 DB 한 행으로 표현한다
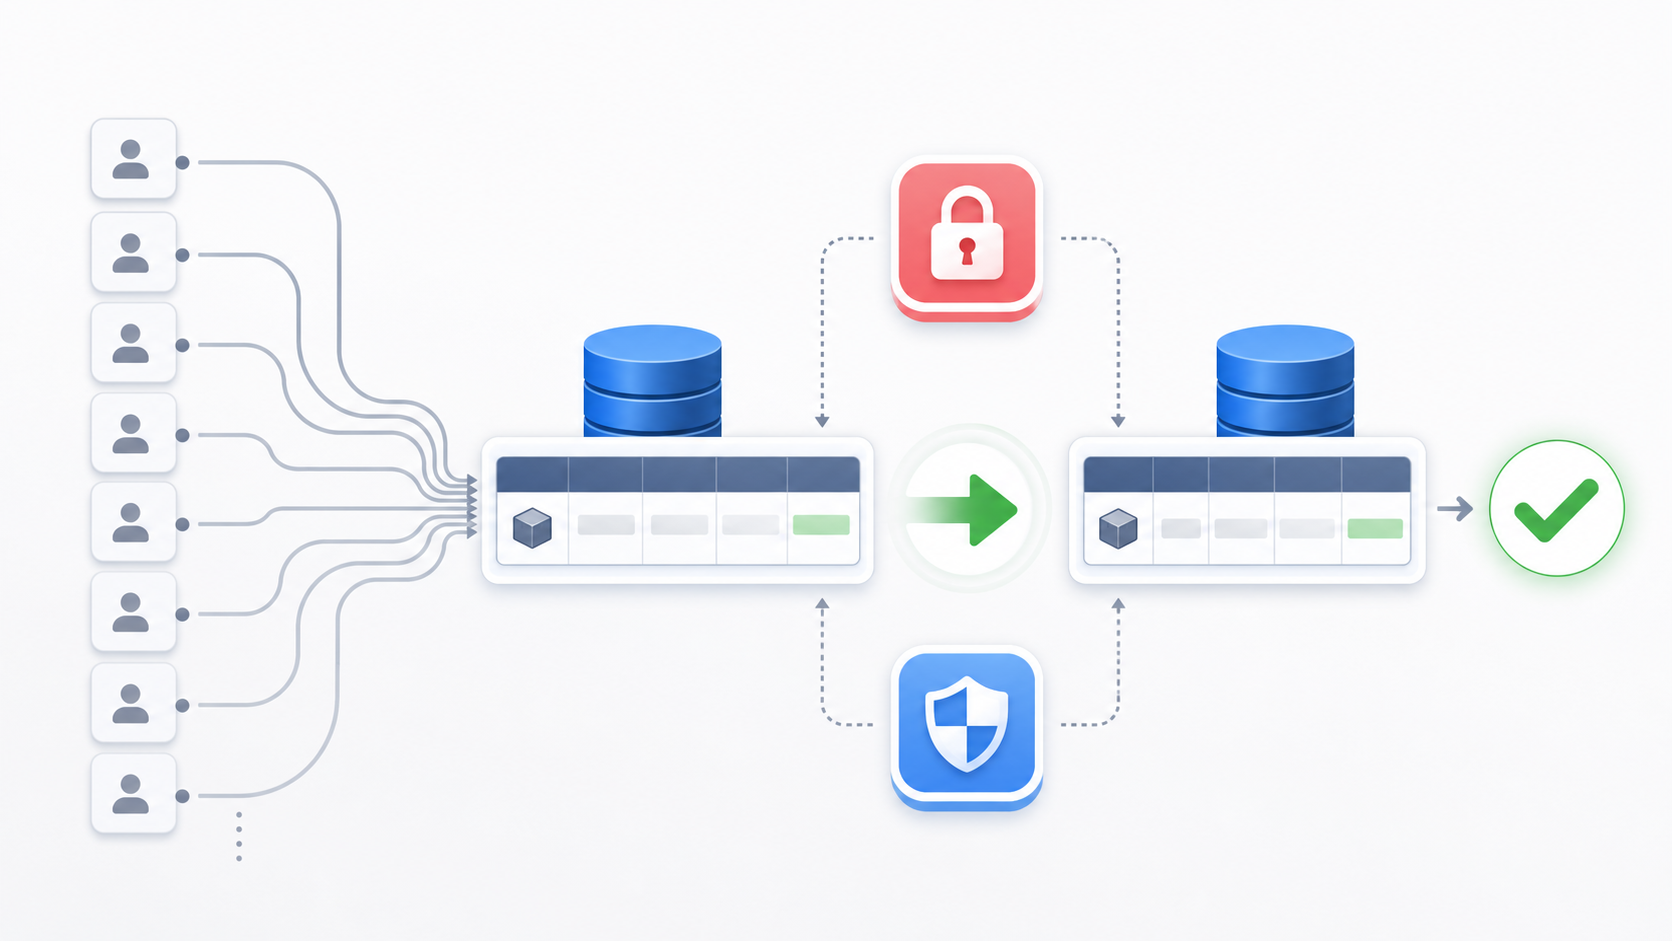
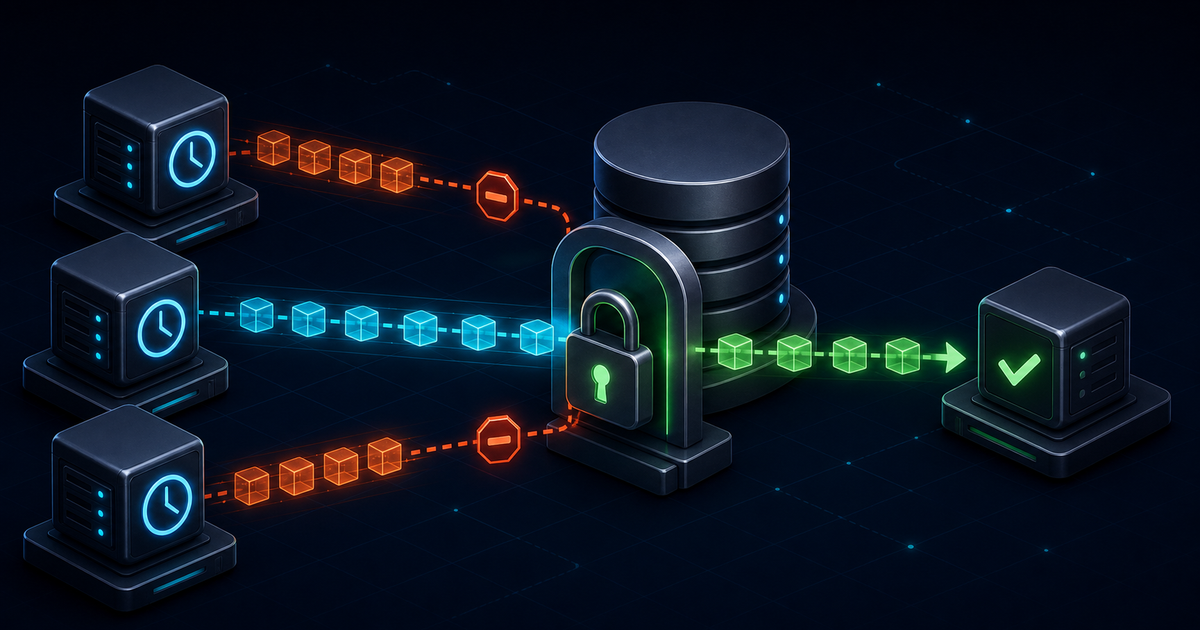
ShedLock 의 발상은 단순합니다. 클러스터 어디에도 조율자가 없으니, 모두가 공유하는 한 곳(여기선 MySQL)에 “이 작업은 지금 누가, 언제까지 쥐고 있다”를 적어 두고 스케줄러가 깨어날 때마다 그 행을 보고 들어갈지 말지를 정합니다.
flowchart TD
    A["3개 Pod의 @Scheduled가<br/>거의 동시에 깨어남"] --> B{"shedlock 행에<br/>락 획득 시도<br/>(원자적 INSERT/UPDATE)"}
    B -->|"성공한 1개 Pod"| C["작업 실행"]
    B -->|"실패한 나머지 Pod"| D["조용히 반환<br/>(아무것도 안 함)"]
    C --> E["작업 종료 →<br/>lock_until 갱신(해제)"]
모든 Pod은 깨어나긴 합니다. ShedLock 은 타이머를 끄지 않습니다. 세 Pod 모두 @Scheduled 가 정상적으로 실행되고 셋 다 락을 잡으러 DB 에 요청합니다. 다만 락을 잡는 데 성공한 하나만 실제 작업을 하고 나머지는 즉시 빠진다. 이건 Consumer 멱등성 글에서 “exists()는 fast path일 뿐이고, 정확성은 UK가 보장한다”고 했던 것과 같은 사고방식입니다. ShedLock 의 정확성도 전적으로 DB 락 레코드의 원자적 획득이 보장합니다. 정확한 동작은 “모두 스케줄링하되 하나만 이긴다”입니다.
이 설계의 결정 두 가지를 짚습니다.
왜 Redis가 아니라 DB인가
PeekCart엔 이미 분산 락이 있습니다. 재고 차감 락은 Redisson(Redis)으로 구현했습니다. 그런데 스케줄러 락은 JdbcTemplateLockProvider 즉 MySQL을 씁니다. 같은 프로젝트가 두 가지 분산 락 인프라를 쓰는 셈인데, 이건 의도된 선택입니다.
| 재고 분산 락 (Redisson) | 스케줄러 락 (ShedLock / JDBC) | |
|---|---|---|
| 보호 대상 | 도메인 자원 (특정 상품 재고) | 주기 작업 (스케줄러 메서드) |
| 락 생명주기 | 요청 단위 (수십 ms~수 초) | 주기 단위 (5초~분 단위) |
| 경합 빈도 | 높음 (동시 주문 폭주 시 초당 수백) | 낮음 (5초/60초에 한 번) |
| 요구 성능 | 낮은 지연이 중요 (주문 응답 경로) | 지연 무관 (백그라운드) |
| 저장소 | Redis | MySQL |
재고 락은 사용자 주문 응답 경로에 있어 매 요청 수 ms 안에 잡고 풀어야 하고 경합이 격심합니다. 인메모리 Redis 가 맞습니다. 반면 스케줄러 락은 5초, 60초에 한 번, 백그라운드에서 잡힙니다. PeekCart 에 Redis 가 이미 있더라도, 이 저빈도 작업은 ShedLock 이 제공하는 JDBC 저장소를 써서 애플리케이션이 이미 의존하는 MySQL 안에서 단순하게 관리할 수 있습니다. 처음 선택할 때 정한 이유도 “이미 MySQL을 쓰고 있으므로 별도 인프라가 불필요하다”였습니다. DB 행으로 락 상태가 남으니 locked_at, locked_by, lock_until 을 SQL로 바로 조회할 수 있다는 운영상 장점도 있습니다.
물론 공짜는 아닙니다. 스케줄러 락 쿼리가 MySQL 에 추가 부하를 줍니다. 특히 Outbox 폴링은 5초마다라, Pod마다 5초에 한 번씩 shedlock 행에 락 쿼리를 날립니다. 앞선 부하 테스트에서 MySQL 이 병목 후보로 지목된 걸 생각하면 무시할 수만은 없지만, 5초에 PK 한 행을 UPDATE하는 비용은 폴링 쿼리(findPendingEvents) 자체에 비하면 미미해서 실용적으론 받아들일 만한 트레이드오프입니다. 락을 못 잡은 Pod도 같은 쿼리를 날리는 비용은 뒤의 「한계」 절에서 따로 봅니다.
왜 작업 자체가 멱등/재진입 가능해야 하는가: ShedLock은 상호 배제다
여기가 ShedLock 을 안전하게 쓰는 전제입니다. ShedLock 이 보장하는 건 정확히 **“같은 시점에 최대 한 노드에서만”(상호 배제)**이지, “주기당 정확히 한 번”도 “반드시 한 번”(at-least-once)도 아닙니다. 두 방향으로 어긋날 수 있습니다. (1) 락을 잡은 Pod 이 작업 도중 죽으면 그 작업은 그냥 안 일어나고 lockAtMostFor 만료 후 다음 발화 때 누군가 다시 잡아 처리합니다(건너뜀). (2) 반대로 트리거 편차가 lockAtLeastFor 보다 크거나 lockAtMostFor 가 실행 중 만료되면, 같은 주기에 두 번 돌 수도 있습니다(겹침). 즉 “주기 경계”라는 전역 개념은 ShedLock 에 없습니다. 있는 건 “지금 이 순간 둘이 동시에 들어오지 못한다”뿐입니다.
그래서 두 스케줄러는 “한 주기를 건너뛰어도 다음 주기가 메꾼다”가 맞도록 짜여 있어야 합니다. 실제로 그렇습니다.
- 주문 취소: 한 주기를 건너뛰어도
#42는 여전히PAYMENT_REQUESTED에 컷오프 이전이라, 다음 60초 주기의findByStatusAndOrderedAtBefore가 또 잡습니다. 쿼리 자체가 “아직 처리 안 된 것”을 정의하므로 재진입이 자연스럽습니다. - Outbox 폴링: 한 주기를 건너뛰어도 그 이벤트는 여전히
PENDING이라, 다음 5초 주기가 또 발행합니다(Outbox 글).
즉 두 작업 다 상태를 기준으로 다시 시도할 수 있는 작업이라, 건너뛰어도(“이번 주기에 못 했으면 다음 주기에”) 겹쳐도(같은 후보를 두 Pod 이 다시 시도해도 앞 절의 재고 @Version/processed_events 가 흡수) 결과가 같아집니다. 작업 본문이 언제나 완전히 멱등한 것은 아니지만 하위 방어선까지 포함한 시스템은 재시도 후 같은 결과에 이르도록 설계되어 있습니다. 이 성질이 있어야 ShedLock 의 상호 배제 만으로 충분합니다. 만약 “정확히 이 시각에 반드시 한 번”이 요구되는 작업(예: 외부에 한 번만 보내야 하는 정산 마감)이었다면, 건너뜀, 겹침 양쪽 다 사고가 되므로 ShedLock만으로는 부족하고 별도 보장이 필요했을 것입니다. 다행히 PeekCart 의 두 작업은 그렇지 않습니다.
구현 구조
1. shedlock 테이블: 락 이름 하나당 행 하나
Flyway 마이그레이션으로 테이블을 만듭니다. 구조는 ShedLock 이 요구하는 표준 스키마 그대로입니다.
CREATE TABLE shedlock (
    name       VARCHAR(64)  NOT NULL,
    lock_until TIMESTAMP(3) NOT NULL,
    locked_at  TIMESTAMP(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3),
    locked_by  VARCHAR(255) NOT NULL,
    PRIMARY KEY (name)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
네 컬럼의 의미가 곧 ShedLock 의 동작입니다.
name: 락 식별자이자 PK.@SchedulerLock(name = ...)의 값이 그대로 들어갑니다. PK라서 락 이름 하나당 행은 영원히 하나입니다. 행이 새로 쌓이지 않고 같은 행이 계속 갱신됩니다(Consumer 멱등성 글의processed_events가 처리마다 행이 쌓이는 것과 대조적입니다).lock_until: 이 시각까지 락이 유효하다. 다른 노드는lock_until <= now일 때만 락을 빼앗을 수 있습니다.TIMESTAMP(3)로 밀리초 정밀도를 둔 건 5초 주기처럼 짧은 작업에서 시각 비교가 거칠면 안 되기 때문입니다.locked_at: 락을 마지막으로 잡은 시각.lockAtLeastFor계산의 기준점입니다.locked_by: 누가 잡았는지(호스트명/Pod명). 사람이 “지금 어느 Pod이 쥐고 있나”를 보는 디버깅 용도이기도 하지만 기능적 역할도 있다. 해제 SQL 의WHERE에locked_by가 들어가, 노드는 자기가 잡은 락만 풀 수 있다(4절). 락이lockAtMostFor만료로 다른 Pod 에 넘어간 뒤 원래 Pod 이 뒤늦게 해제를 시도해도,locked_by가 안 맞아 남의 락을 풀지 못합니다.
2. ShedLockConfig: 한 번의 설정
설정은 클래스 하나가 전부입니다.
@Configuration
@EnableSchedulerLock(defaultLockAtMostFor = "PT10M")
public class ShedLockConfig {

    @Bean
    public LockProvider lockProvider(DataSource dataSource) {
        return new JdbcTemplateLockProvider(
                JdbcTemplateLockProvider.Configuration.builder()
                        .withJdbcTemplate(new JdbcTemplate(dataSource))
                        .usingDbTime()                    // ← DB 서버 시계로 락 만료 비교
                        .build()
        );
    }
}
두 가지가 핵심입니다.
@EnableSchedulerLock: ShedLock 의 AOP 를 켭니다. @SchedulerLock 이 붙은 메서드를 가로채, 실행 전에 락 획득을 시도하고 실패하면 메서드 본문을 통째로 건너뛰는 어드바이스를 끼웁니다. defaultLockAtMostFor = "PT10M" 은 lockAtMostFor 를 명시 안 한 @SchedulerLock 에 적용될 기본값인데 PeekCart 의 두 스케줄러는 둘 다 자기 값을 명시하므로(아래), 이 기본값은 사실상 안전망일 뿐 실제로 쓰이지 않습니다.
usingDbTime(): 이게 분산 환경에서 사실상 필수인 설정입니다. ShedLock 이 하는 모든 확인은 “지금이 lock_until을 지났나”라는 시각 비교입니다. 이 비교를 각 앱 Pod의 로컬 JVM 시계로 하면, Pod들의 시계가 조금만 어긋나도(클라우드 VM 에서 흔합니다) 한 Pod 은 “아직 락 유효”라 보고 다른 Pod 은 “이미 만료”라 봐서 둘 다 작업을 실행하는 사고가 납니다. usingDbTime() 을 켜면 락 획득/해제 SQL 이 NOW() 같은 DB 서버 시각을 쓰도록 바뀝니다. 비교 기준이 MySQL 하나로 통일돼, 앱 노드 간 시계 오차가 비교에 영향을 주지 않습니다.
3. 두 스케줄러에 @SchedulerLock 한 줄
// OrderTimeoutScheduler: 60초 주기
@Scheduled(fixedDelay = 60_000)
@SchedulerLock(name = "orderTimeoutCancelJob", lockAtMostFor = "PT10M", lockAtLeastFor = "PT30S")
public void cancelExpiredOrders() { ... }

// OutboxPollingScheduler: 5초 주기
@Scheduled(fixedDelay = 5000)
@SchedulerLock(name = "outboxPollingJob", lockAtMostFor = "PT5M", lockAtLeastFor = "PT4S")
public void pollAndPublish() { ... }
name 은 두 작업이 서로 다른 락을 쓰도록 구분합니다. orderTimeoutCancelJob 과 outboxPollingJob 은 shedlock 테이블의 별개 행이라 주문 취소와 Outbox 폴링은 서로를 막지 않고 각자 독립적으로 “하나만 실행”됩니다. lockAtMostFor/lockAtLeastFor 두 값이 이 절의 핵심이라 따로 봅니다.
4. @SchedulerLock이 붙으면 도는 SQL
추상적인 “락을 잡는다”를 SQL로 내려보겠습니다. 아래는 ShedLock 6.3.1의 usingDbTime() 경로(MySqlServerTimeStatementsSource)가 실제로 쓰는 문장입니다(:name 같은 named parameter 는 그대로 두었습니다). 락을 잡을 때 하는 일은 두 단계입니다.
락 획득: 먼저 INSERT IGNORE 를 시도합니다.
INSERT IGNORE INTO shedlock (name, lock_until, locked_at, locked_by)
VALUES (:name,
        TIMESTAMPADD(MICROSECOND, :lockAtMostForMicros, UTC_TIMESTAMP(3)),  -- lock_until = now + lockAtMostFor
        UTC_TIMESTAMP(3),
        :lockedBy);
행이 없으면(최초 실행) 삽입에 성공하고 락을 얻습니다. 행이 이미 있으면 INSERT IGNORE 라 PK 충돌을 조용히 무시하고 0행이 들어갑니다. 그러면 UPDATE로 넘어갑니다.
UPDATE shedlock
   SET lock_until = TIMESTAMPADD(MICROSECOND, :lockAtMostForMicros, UTC_TIMESTAMP(3)),
       locked_at  = UTC_TIMESTAMP(3),
       locked_by  = :lockedBy
 WHERE name = :name
   AND lock_until <= UTC_TIMESTAMP(3);   -- ← 이전 락이 이미 만료된 경우에만
이 UPDATE 가 원자적 경쟁의 핵심입니다. WHERE lock_until <= UTC_TIMESTAMP(3) 는 “현재 락이 만료됐을 때만” 갱신합니다. 세 Pod 이 동시에 이 UPDATE 를 날려도, MySQL 의 행 잠금이 직렬화해서 딱 한 Pod의 UPDATE만 1행을 affect하고 나머지는 0행이 됩니다. ShedLock 은 “1행이 바뀌었으면 락 획득 성공, 0행이면 실패”로 봅니다. 시각이 전부 UTC_TIMESTAMP(3)(DB 서버 시각)인 게 usingDbTime() 의 효과입니다.
락 해제: 작업이 끝나면 락을 풉니다. 그런데 그냥 지우는 게 아니라 lock_until 을 갱신합니다.
UPDATE shedlock
   SET lock_until = IF(TIMESTAMPADD(MICROSECOND, :lockAtLeastForMicros, locked_at) > UTC_TIMESTAMP(3),
                       TIMESTAMPADD(MICROSECOND, :lockAtLeastForMicros, locked_at),
                       UTC_TIMESTAMP(3))
 WHERE name = :name
   AND locked_by = :lockedBy;            -- ← 자기가 잡은 락만 푼다
두 가지를 짚습니다. (1) IF(...) 는 “작업이 lockAtLeastFor보다 빨리 끝났으면 locked_at + lockAtLeastFor 시각까지 락을 유지하고, 그보다 오래 걸렸으면 지금 즉시 푼다”입니다. lockAtLeastFor 가 이렇게 강제됩니다. (2) WHERE 의 AND locked_by = :lockedBy 가 1절에서 말한 “자기 락만 해제” 보호입니다. 만약 이 작업이 lockAtMostFor 를 넘겨 락이 이미 다른 Pod으로 넘어갔다면(locked_by 가 바뀜), 뒤늦은 이 해제는 0행을 affect해 남의 락을 풀지 못한다. 해제가 행을 지우지 않고 lock_until 만 갱신하는 덕에 행은 영구히 재사용됩니다.
5. lockAtMostFor와 lockAtLeastFor: 막는 실패가 다르다
이 두 값이 ShedLock 설정의 전부이자 가장 헷갈리는 부분입니다. 둘은 정반대 방향의 실패를 막습니다.
lockAtMostFor: “락을 쥔 채 죽는” 실패를 막는다 (상한)
락을 잡은 Pod 이 작업 도중 크래시하면(OOM, Pod 강제 종료 등) 정상적인 해제 SQL 을 실행할 기회가 없습니다. lockAtMostFor 는 락을 잡을 때부터 lock_until = now + lockAtMostFor 로 강제 만료선을 기록합니다. 죽은 Pod 의 락도 이 시간이 지나면 만료된 것으로 취급되어, 다른 Pod 이 이어받을 수 있습니다.
값 선정의 트레이드오프가 여기 있습니다. lockAtMostFor 는 작업의 최대 실행 시간보다 반드시 길어야 합니다. 너무 짧으면 작업이 그 시간보다 오래 실행 중인데 락이 만료돼버려, 다른 Pod이 같은 작업을 동시에 시작합니다(중복 실행 재발!). 너무 길면 진짜로 죽었을 때 그 시간만큼 작업이 멈춰 있습니다. PeekCart 는 주문 취소 PT10M, Outbox 폴링 PT5M 로 잡았습니다. 분 단위로 크게 잡은 건 “중복 실행 위험”보다 “크래시 시 복구 지연”을 택한 보수적 선택입니다. 중복은 더 비싼 사고이므로 안전 마진을 뒀습니다. 다만 여기엔 함정이 있습니다. “작업의 최대 실행 시간”이 코드로 한정돼 있지 않습니다(특히 Outbox 폴링). 정상 경로에선 수 초로 끝나지만 브로커가 느려지면 그렇지 않습니다. 「한계」절에서 자세히 봅니다.
lockAtLeastFor: “너무 빨리 풀려서 같은 주기에 또 도는” 실패를 막는다 (하한)
이쪽이 덜 직관적입니다. 작업이 아주 빨리 끝나는 경우를 생각해 보겠습니다. Outbox 폴링이 PENDING 이벤트가 하나도 없어 10ms 만에 끝났다고 하겠습니다. lockAtLeastFor 가 없으면 락이 10ms 만에 풀립니다. 그런데 Pod A의 5초 타이머와 Pod B의 5초 타이머는 시작 시각이 미세하게 어긋나 있습니다(시계 오차 + 스케줄링 지터). Pod A가 락을 잡아 10ms 만에 끝내고 풀었는데 50ms 뒤 Pod B의 타이머가 깨어나 보니 락이 비어 있습니다. 그래서 Pod B가 또 같은 주기 작업을 합니다. 같은 5초 구간에 두 번 실행된 것입니다. lockAtLeastFor 는 “아무리 빨리 끝나도 최소 이만큼은 락을 쥐고 있어라”라고 해서 이 시계 오차 창을 덮습니다.
그래서 lockAtLeastFor 는 같은 주기 안의 예상 지터를 덮되 정상적인 다음 주기는 막지 않는 값으로 잡습니다. Phase 2에서 정한 근거와 같습니다. 주문 취소는 60초 주기에 PT30S, Outbox 는 5초 주기에 PT4S. 주기 전체를 잠그는 게 아니라, 작업이 너무 빨리 끝난 직후 다른 Pod 이 뒤늦게 들어오는 시간 차이로 인한 중복 실행을 막는 값입니다.
| 막는 실패 | 방향 | PeekCart 값 | |
|---|---|---|---|
lockAtMostFor | 락 쥔 채 노드 크래시 시 영구 교착 | 상한 (최대 보유) | 주문 PT10M / Outbox PT5M |
lockAtLeastFor | 작업 조기 종료 + 시계 오차로 같은 주기 중복 | 하한 (최소 보유) | 주문 PT30S / Outbox PT4S |
두 값은 “크래시 복구”와 “중복 방지”라는 양쪽 끝을 각각 잡습니다. 하나만 있으면 다른 쪽은 막지 못합니다.
한계와 트레이드오프
Phase 2에서는 ShedLock이 사실상 dead weight다
먼저 짚어야 할 점입니다. Phase 2는 단일 인스턴스입니다. Pod 이 하나면 스케줄러 중복 실행 자체가 일어날 수 없으니, ShedLock 이 막을 문제가 없습니다. 그런데도 Phase 2에 ShedLock 을 넣었습니다. shedlock 행을 잡고 푸는 SQL 이 5초, 60초마다 도는데 그게 막아주는 사고는 Phase 2엔 존재하지 않습니다. 순수하게 보면 부하만 더하고 이득은 0인 코드입니다.
설계 단계에서는 이걸 명시적 선택으로 두었습니다. “Phase 2에서는 단일 인스턴스이므로 ShedLock의 분산 락 기능이 즉시 필요하지 않다. 그러나 스케줄러 구현 시점(Phase 2)에 함께 적용하여 Phase 3~4 분산 환경 전환 시 추가 작업 비용을 제거한다.” 즉 마이그레이션 비용의 선지급입니다. 결제 타임아웃 스케줄러 글 말미의 “지금은 단일 인스턴스지만, 분산을 가정한 형태로 미리 염두에 둔다”와 같은 논리입니다. 이게 정당한지는 갈립니다. (1) 적용 비용이 애너테이션 한 줄 + 설정 한 클래스로 극히 작고 (2) Phase 3 HPA 가 확정된 로드맵이라 “곧 반드시 필요한 것”이며 (3) 나중에 분산 사고가 터진 뒤 붙이면 이미 중복 실행된 데이터를 수습해야 합니다. 예정된 부채를 미리 갚는 쪽에 가깝습니다. 그래도 “Phase 2 시점엔 끄고 Phase 3 overlay에서 켜는” 선택지도 있었다는 건 인정해야 합니다.
lockAtMostFor는 작업 시간을 추측한 값이다
lockAtMostFor 의 안전성은 “작업이 이 시간 안에 끝난다”는 전제에 달려 있습니다. 그런데 Outbox 폴링의 실제 최대 실행 시간은 코드로 한정돼 있지 않습니다. Outbox 글에서 본 OutboxPollingService 의 kafkaTemplate.send(...).get() 은 타임아웃 인자가 없고 한 사이클이 BATCH_SIZE=100건을 순차로 .get() 합니다. 여기서 흔한 오해를 짚어야 합니다. delivery.timeout.ms(기본 120초)는 레코드 한 건의 상한이지 사이클 전체의 상한이 아닙니다. 브로커가 느려지면 건당 최대 ~120초가 100건에 누적될 수 있어, 산술적으로 3건째부터도 5분(PT5M)을 넘길 수 있다. 게다가 send() 자체가 메타데이터 확보를 위해 블록하는 max.block.ms(기본 60초)도 별도로 더해질 수 있습니다.
그래서 지금 값이 안전하다고 말할 근거가 없습니다. 현재 코드는 폴링 사이클의 실행 시간 상한을 증명하지 못합니다. 사이클이 PT5M 을 넘기면 ShedLock 이 락을 만료시켜 다른 Pod이 폴링을 동시에 시작하고, 중복 발행이 생깁니다. 다행히 그 중복마저 Consumer 멱등성이 받아내도록 설계돼 있어 정합성은 안 깨지지만 “ShedLock의 lockAtMostFor와 producer 타임아웃은 한 손잡이의 양면”이라는 건 분명합니다. .get() 에 타임아웃이 없는 문제를 고칠 때 .get(timeout), delivery.timeout.ms, max.block.ms 로 사이클 상한을 먼저 한정하고, 그 상한과 정합하도록 lockAtMostFor 를 잡아야 비로소 “락보다 오래 사는 작업”을 막을 수 있습니다.
락을 놓친 Pod의 타이머도 fixedDelay 간격으로 계속 돈다
fixedDelay 는 “이전 실행 종료 후 N ms 뒤 다음 실행”입니다. 그런데 ShedLock으로 락을 못 잡아 즉시 빠진 Pod 에서는, 그 “실행”이 사실상 0ms 만에 끝난 것으로 처리됩니다. 그래서 락을 계속 놓치는 Pod 의 타이머는 fixedDelay 간격으로 불필요하게 반복 실행됩니다. 5초마다 깨어나 락을 시도하고, 실패하면 즉시 반환하고, 5초 뒤 또 시도합니다. 무해하지만 “락을 못 잡는 Pod들도 주기마다 DB 락 쿼리를 날린다”는 비용은 있습니다. 앞 「왜 Redis가 아니라 DB인가」 절에서 말한 MySQL 추가 부하가 이 쿼리입니다. Pod 3개면 Outbox 락 쿼리가 5초에 3번 발생하고 그중 2번은 “0행 UPDATE”로 끝나, 단일 인스턴스 대비 락 경쟁 쿼리가 인스턴스 수만큼 늡니다.
락 이름 충돌은 컴파일 타임에 안 잡힌다
@SchedulerLock(name = "...") 의 name 은 문자열 상수입니다. 만약 두 다른 스케줄러에 같은 name 을 실수로 주면, ShedLock 은 둘을 같은 락으로 취급해 한쪽이 돌 때 다른 쪽이 막힙니다. 전혀 무관한 두 작업이 서로를 배제하는 silent bug입니다. 컴파일러도 ShedLock 도 이걸 잡아주지 않습니다. 현재는 orderTimeoutCancelJob/outboxPollingJob 둘뿐이라 문제없지만 작업이 늘면 락 이름을 상수로 모아 관리하거나 네이밍 규칙을 두면 더 안전합니다. Phase 4에서 서비스가 쪼개지면 더 그렇습니다.
스케줄러 락이 MySQL의 가용성에 묶이는 것은 LockProvider 선택의 결과다
스케줄러 락이 MySQL 의 가용성에 묶이는 건 JdbcTemplateLockProvider를 고른 시점에 생긴 의존성입니다. 락 상태를 DB 테이블에 두기로 한 결정 그 자체. usingDbTime() 은 그 의존성과 별개로, 이미 DB 에 둔 락의 만료 비교 기준을 DB 시계로 통일하는 선택입니다. MySQL 이 죽으면 락을 잡을 수도 풀 수도 없어 스케줄러가 멈추지만, 앱 자체가 애초에 그 MySQL 에 의존하므로 “DB가 죽으면 어차피 다 멈춘다”는 큰 그림 안에 있습니다. Phase 4에서 서비스별 DB로 쪼개지면 각 서비스의 스케줄러가 자기 DB 의 shedlock 을 쓰게 돼 그 의존 범위가 서비스 단위로 좁아집니다(뒤 절).
통합 테스트로 검증된 것과 못한 것
ShedLockIntegrationTest 는 Testcontainers로 MySQL + Redis + Kafka 를 띄우고 실제 스케줄러가 도는 걸 관찰합니다. spring.task.scheduling.pool.size=1 로 스케줄러 스레드를 묶어두고 두 가지를 assert 합니다.
1. shedlock 테이블이 Flyway로 생성되고, 스케줄러 실행 시 락 레코드가 기록된다
// 테이블 존재 확인
Integer tableCount = jdbcTemplate.queryForObject(
        "SELECT COUNT(*) FROM information_schema.tables WHERE table_schema = DATABASE() AND table_name = 'shedlock'",
        Integer.class);
assertThat(tableCount).isEqualTo(1);

// 스케줄러가 돌면 락 레코드가 생긴다
await().atMost(Duration.ofSeconds(15)).pollInterval(Duration.ofSeconds(1))
        .untilAsserted(() -> {
            Integer lockCount = jdbcTemplate.queryForObject("SELECT COUNT(*) FROM shedlock", Integer.class);
            assertThat(lockCount).isGreaterThanOrEqualTo(1);
        });
2. outboxPollingJob 락 레코드가 생성된다. name = 'outboxPollingJob' 행이 정확히 1건 생기는지 확인합니다. 락 이름이 의도대로 행으로 매핑되는지를 봅니다.
이 두 테스트가 증명하는 건 **“배선이 됐다”**는 것입니다. Flyway 가 테이블을 만들고 @EnableSchedulerLock 이 동작해 스케줄러 실행이 shedlock 행으로 이어집니다. 즉 ShedLock 이 켜져 있고 락을 기록합니다.
그런데 이 테스트가 증명하지 못한 것이 ShedLock의 존재 이유 그 자체다.
- 상호 배제(여러 인스턴스 중 하나만 실행)를 검증하지 않는다. 테스트는 단일 Spring 컨텍스트에서 실행됩니다. Pod 이 하나뿐이니 애초에 경쟁이 없습니다. “두 인스턴스가 같은 주기에 깨어났을 때 하나만 작업을 실행하더라”라는, ShedLock 을 도입한 유일한 이유는 코드 어디서도 assert 되지 않습니다. Consumer 멱등성 글에서 “동시 중복(UK 충돌 경로)을 재현하지 않는다”가 멱등성의 핵심 검증 공백이었던 것과 정확히 같은 종류의 공백입니다. 헤드라인 보장이 테스트되지 않았습니다.
lockAtLeastFor/lockAtMostFor의 효과를 검증하지 않는다. 조기 종료 시 락이 최소 시간 유지되는지, 크래시 시 최대 시간 후 풀리는지, 둘 다 코드 읽기와 ShedLock 라이브러리 신뢰에 맡겨져 있습니다.usingDbTime()의 시계 오차 방어를 검증하지 않는다. 노드 간 시계를 어긋나게 만드는 시나리오가 없으니, DB 시각 사용이 실제로 무엇을 막는지는 논증으로만 남습니다.
상호 배제를 통합 테스트로 확인하려면 두 개의 독립된 락 제공자(또는 두 컨텍스트)가 같은 shedlock 테이블을 두고 경쟁하게 만들어, 동시에 작업을 트리거했을 때 한쪽만 실행 카운터를 올리는 걸 assert 해야 합니다. 지금은 그게 없습니다. 정리하면, 테스트는 **“ShedLock이 배선되어 락을 기록한다”**는 검증하지만 **“경쟁 시 하나만 이긴다”**는 설계의 본질은 검증 공백으로 남아 있습니다.
Phase 4 MSA에서는 어떻게 바뀌는가
ShedLock 은 Phase 2에 만들었지만 Phase 3 HPA 에서 비로소 일을 시작했고 Phase 4에서는 그 필요가 더 커집니다. 서비스가 쪼개져도 각 서비스가 여러 Pod으로 뜨는 한 스케줄러 중복 문제는 그대로 남기 때문입니다.
flowchart LR
    subgraph OrderSvc["Order Service (N Pods)"]
        OS["orderTimeoutCancelJob"]
        ODB[("Order DB<br/>shedlock")]
        OS --> ODB
    end
    subgraph OtherSvc["각 서비스 (N Pods)"]
        XS["outboxPollingJob<br/>(+ retention 청소?)"]
        XDB[("서비스 DB<br/>shedlock")]
        XS --> XDB
    end
그대로 가는 것
- 상호 배제 + 재시도 후 같은 결과에 이르는 작업이라는 전제. 서비스가 쪼개져도 “건너뛰면 다음 주기가 메꾸고, 겹쳐도 하위 방어선이 흡수한다”는 성질은 변하지 않습니다. 오히려 분산에서 노드 크래시가 더 흔해지므로 이 전제 위에 선 ShedLock 의 상호 배제가 더 잘 맞습니다.
- DB 기반 락 선택. 각 서비스가 자기 DB 를 갖게 되면, 스케줄러 락도 그 서비스 DB 의
shedlock을 쓰면 됩니다. 별도 락 인프라가 필요 없다는, 분산 락과 비교한 장점이 서비스마다 그대로 유지됩니다. lockAtMostFor/lockAtLeastFor의 의미. 결제 타임아웃 스케줄러 글에서 “ShedLock은 Phase 4에서도 그대로 유효하다”고 한 그대로입니다.
바뀌는 것
shedlock테이블이 서비스별로 분산된다. 단일 테이블이 N개가 됩니다.orderTimeoutCancelJob은 Order Service DB 의shedlock에, Outbox 폴링은 각 발행 서비스의 DB 에 있습니다. SPOF 범위가 “전체 MySQL”에서 “서비스별 DB”로 좁아지는 건 이득입니다. 한 서비스 DB 가 죽어도 다른 서비스 스케줄러는 멀쩡합니다.- 락 이름의 전역 유일성 부담이 사라진다. 모놀리스에선 모든 락이 한 테이블을 공유해 이름 충돌(앞 「한계」절)이 위험이었지만 서비스별 테이블로 갈라지면 같은 이름이 다른 서비스에 있어도 무관합니다. 다만 한 서비스 안의 유일성은 여전히 챙겨야 합니다.
- 스케줄러의 소속이 결정된다. 결제 타임아웃 스케줄러 글에서 본 대로 주문 취소 스케줄러는 Order Service로 가고 재고 복구는 동기 호출에서
order.cancelled이벤트로 바뀝니다. Outbox 폴링은 이벤트를 발행하는 각 서비스가 자기 Outbox 폴러를 갖는다(Outbox 글). 즉outboxPollingJob이 서비스 수만큼 복제되고 각자 자기 서비스 DB 의shedlock으로 보호됩니다.
그래서 Phase 4 진입 전 짚을 점
- retention 청소 스케줄러도 ShedLock으로 묶인다. Outbox 글(
outbox_events누적)과 Consumer 멱등성 글(processed_events누적)에서 미뤄둔 청소 정책을 실제 구현할 때, 그 배치 삭제 스케줄러 역시 다중 Pod 에서 한 번만 돌아야 합니다. 이 글의@SchedulerLock패턴을 그대로 재사용하면 됩니다. 두 누적 테이블 청소를 한 작업 단위로 묶고 그 위에 ShedLock 을 입히는 게 자연스러운 경로입니다. - 상호 배제를 카오스/멀티노드 테스트로 박아야 한다. 앞 「통합 테스트」 절의 공백이 분산에선 필수 검증이 됩니다. Consumer 멱등성 글의 동시 중복, 실패 재처리 검증 공백과 함께, Phase 4 전에 “두 인스턴스가 같은 락을 두고 경쟁할 때 정말 하나만 실행되는가”를 검증하는 게 부채 점검 글에서 챙길 항목입니다.
lockAtMostFor와 producer/작업 타임아웃의 결합을 명시화한다. 앞 「한계」 절에서 본 대로,.get()의 타임아웃을 고칠 때 Outbox 폴링의lockAtMostFor와 producerdelivery.timeout.ms를 정합하는 상한으로 함께 잡아야 “작업이 락보다 오래 살아 중복 실행”되는 경로가 차단됩니다.
정리하며
처음 질문으로 돌아가면, @Scheduled 는 JVM 프로세스마다 타이머를 하나씩 만들어서 Pod이 3개가 되면 같은 작업이 세 번 돕니다. 주문 취소에서는 Order 에 동시성 제어가 없어 동시 경합을 재고 @Version 이 막고, Outbox 폴링에서는 같은 이벤트가 토픽에 세 번 들어갑니다. ShedLock 은 shedlock 테이블의 행 하나로 “지금 누가 돌고 있다”를 표현하고, @SchedulerLock 이 붙으면 INSERT IGNORE 와 lock_until <= now 조건의 UPDATE 가 실행됩니다. 스케줄러 락은 5초, 60초에 한 번 백그라운드에서 잡히는 저빈도 락이라 이미 의존하는 MySQL 로 충분했고, 주문 응답 경로에서 매 요청 수 ms 안에 잡고 풀어야 하는 재고 락은 Redis 가 맞았습니다.
usingDbTime() 은 락 만료 비교의 기준을 DB 시계 하나로 통일해 앱 노드 간 시계 오차가 비교에 영향을 주지 않게 합니다. lockAtMostFor 는 락을 쥔 채 죽는 실패를, lockAtLeastFor 는 너무 빨리 풀려 같은 주기에 또 도는 실패를 막습니다. 두 값은 방향이 반대라 둘 다 필요합니다. Phase 2에서는 막을 문제가 없어 부하만 더하는 코드였지만, 적용 비용이 작고 Phase 3 HPA 가 확정된 로드맵이라 미리 적용했고, 예정된 부채를 미리 갚는 쪽에 가깝다고 보았습니다. Phase 2에는 끄고 Phase 3 overlay에서 켜는 선택지도 있었습니다. 통합 테스트는 ShedLock 이 배선되어 락을 기록한다는 것까지만 확인했고, 경쟁 시 하나만 이긴다는 보장은 아직 검증하지 못했습니다.
자료는 어떤 질문에 연결해서 읽을까
| 질문 | 같이 읽을 자료 | 이 글에서 연결되는 지점 |
|---|---|---|
@Scheduled는 어느 범위에서 도는가 | Spring Framework Reference, Task Execution and Scheduling | ”문제 상황” 절 |
| 분산 환경 스케줄러 중복 실행과 ShedLock | ShedLock 공식 README | 전반 |
lockAtMostFor/lockAtLeastFor 의미 | ShedLock README, Lock at most/least for | 5절 두 값 비교 |
usingDbTime()과 시계 오차 | ShedLock README, Caveats / using database time | 2절 설정 |
| DB 락 vs Redis 락 선택 | 분산 락 글(Redisson) | 「왜 Redis가 아니라 DB인가」 절 |
| 스케줄러가 푸는 두 작업의 원형 | 결제 타임아웃 스케줄러 글, Outbox 글(폴링) | 「문제 상황」 절의 두 작업 |
| 중복 발행을 받아내는 하위 방어선 | Consumer 멱등성 글(processed_events) | 「문제 상황」 절의 Outbox 폴링, 「한계」 절의 lockAtMostFor |
| HPA scale-out 실측 | 동시 주문 부하 테스트 글 | 「문제 상황」 절의 HPA 설정 |