주문은 만들었는데 결제는 끝내지 않은 사용자가 있습니다. 결제 위젯을 열어둔 채 탭을 닫았을 수도 있고 결제 도중 카드사 인증에서 막혔을 수도 있습니다. 문제는 이 미완료 주문이 살아 있는 동안 재고가 묶여 있다는 점입니다. 주문 생성 트랜잭션 글에서 본 “주문 생성 시점에 재고를 즉시 차감”하는 전략을 선택한 순간부터, “그러면 결제를 안 끝낸 주문의 재고는 누가 풀어주는가”라는 질문이 따라붙습니다. 그 질문에 답하는 결제 타임아웃 스케줄러가 이번 글의 주제입니다.
이 연재는 PeekCart를 네 단계로 진행했습니다. Phase 1은 단일 Spring Boot 모놀리스로 도메인을 구현한 단계, Phase 2는 캐시, 분산 락, Kafka와 Outbox로 성능과 정합성을 보강한 단계, Phase 3은 CI, Kubernetes, 관측성, 부하 테스트로 운영 환경을 검증한 단계, Phase 4는 서비스별로 나눈 MSA 단계입니다.
이 글에서 사용하는 용어의 뜻은 다음과 같습니다.
| 용어 | 이 글에서의 의미 |
|---|---|
| 결제 타임아웃 | 주문이 PAYMENT_REQUESTED 상태로 진입한 후 일정 시간(PeekCart 기준 15분) 내 결제가 끝나지 않은 상태 |
| 재고 묶임(stock holding) | 차감은 되었으나 아직 매출로 확정되지 않은 재고. 결제 완료 또는 취소까지의 임시 점유 상태 |
@Scheduled(fixedDelay) | 이전 실행이 끝난 시점을 기준으로 다음 실행까지의 간격. fixedRate(시작 시점 기준)와 다름 |
| 건별 독립 트랜잭션 | 여러 건을 한 번에 처리할 때 각 건마다 자기만의 트랜잭션 경계를 두는 방식. Spring에서 REQUIRES_NEW로 구현 |
| 상태 경합(state race) | 스케줄러가 조회한 주문이, 처리 직전에 다른 흐름(예: 결제 콜백)에 의해 상태가 바뀌어 있는 상황 |
| ShedLock | 다중 인스턴스 환경에서 같은 스케줄러가 동시에 여러 곳에서 돌지 않도록 DB 락으로 단일 실행을 보장하는 라이브러리 (Phase 2 도입) |
이번 학습에서는 다음 질문을 확인하려고 합니다.
- 왜 결제 실패와 결제 타임아웃을 같은 “취소” 흐름으로 묶으면 안 될까?
- 만료 주문을 한 트랜잭션에 묶어 한꺼번에 처리하면 무엇이 문제일까?
REQUIRES_NEW건별 트랜잭션과try-catch실패 격리는 각각 무엇을 막아줄까?findByStatusAndOrderedAtBefore의 인덱스와 JOIN FETCH 는 어떤 비용을 줄일까?- 단일 Pod 에서는 잘 돌던 이 스케줄러가, 다중 Pod 에서는 왜 새로운 문제를 만들까?
문제 상황: 결제하지 않은 주문이 점유한 재고
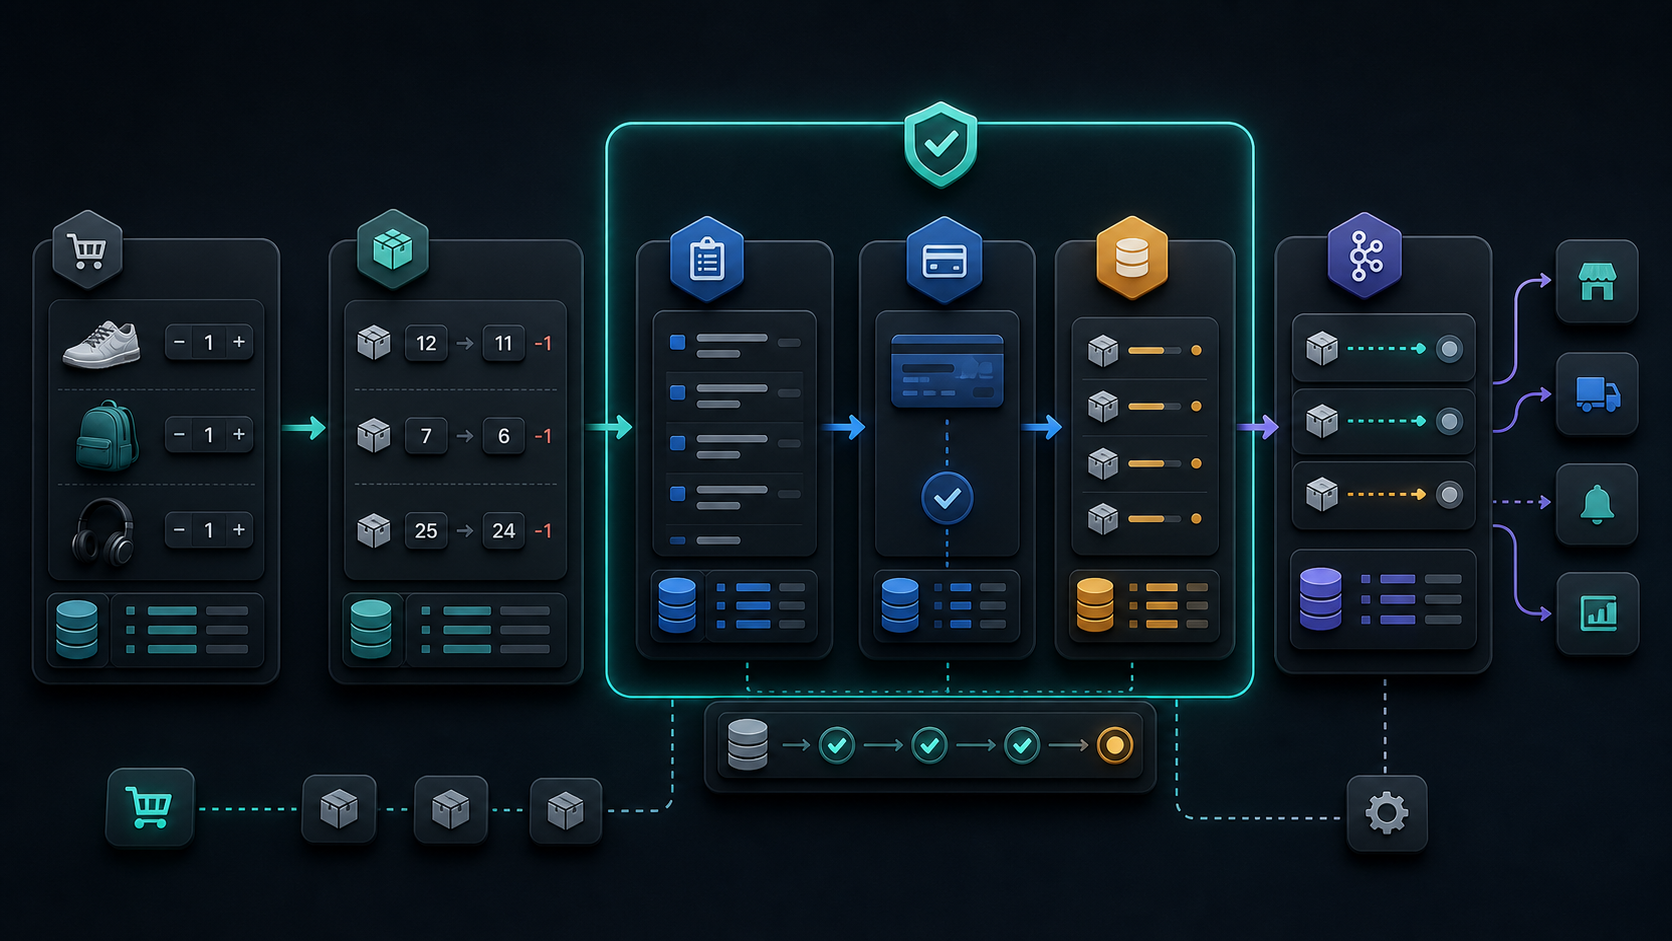
주문 생성 글에서 정리한 트랜잭션을 다시 떠올려보겠습니다. 한 트랜잭션 안에서 (a) Order 저장, (b) Inventory.decrease() 호출, (c) Outbox 이벤트 저장이 한꺼번에 일어납니다. 트랜잭션이 커밋되는 순간 재고는 이미 빠져 있고 주문 상태는 PAYMENT_REQUESTED 로 진입합니다. 이후 사용자가 Toss 결제 위젯에서 승인을 누르면 결제 콜백이 와서 PAYMENT_COMPLETED 로 전이되고 실패하면 PAYMENT_FAILED → CANCELLED 로 떨어지면서 재고가 복구됩니다(결제 실패 흐름 글).
문제는 사용자가 위젯을 열어두고 아무 행동도 하지 않는 경우입니다. 결제 콜백이 영원히 오지 않으면 주문은 PAYMENT_REQUESTED 상태로 남고 그 주문이 차감한 재고는 절대 풀리지 않습니다. 인기 상품이라면 단 한 명의 망설이는 사용자가 다른 100명의 구매 가능 여부를 막을 수 있습니다.
flowchart LR
    Created["주문 생성 / 재고 -1"] --> PR["PAYMENT_REQUESTED"]
    PR -->|결제 승인| Done["PAYMENT_COMPLETED"]
    PR -->|결제 실패 콜백| Failed["PAYMENT_FAILED / CANCELLED / 재고 +1"]
    PR -->|콜백 없음| Stuck["재고 영구 묶임"]
이 주문을 처리하는 것이 결제 타임아웃 스케줄러입니다. Toss Payments 의 결제창 세션이 15분이라는 점에 맞춰, 같은 15분을 컷오프로 잡고 그 이상 머무른 주문을 자동 취소합니다.
OrderTimeoutScheduler
@Component
@RequiredArgsConstructor
@Slf4j
public class OrderTimeoutScheduler {

    private final OrderRepository orderRepository;
    private final OrderCommandService orderCommandService;

    @Scheduled(fixedDelay = 60_000)
    @SchedulerLock(name = "orderTimeoutCancelJob", lockAtMostFor = "PT10M", lockAtLeastFor = "PT30S")
    public void cancelExpiredOrders() {
        LocalDateTime cutoff = LocalDateTime.now().minusMinutes(15);
        List<Order> expiredOrders = orderRepository.findByStatusAndOrderedAtBefore(
                OrderStatus.PAYMENT_REQUESTED, cutoff);

        for (Order order : expiredOrders) {
            cancelSafely(order.getId(), order.getOrderNumber());
        }
    }

    private void cancelSafely(Long orderId, String orderNumber) {
        try {
            orderCommandService.cancelExpiredOrder(orderId);
            log.info("타임아웃 주문 취소: orderId={}, orderNumber={}", orderId, orderNumber);
        } catch (OrderException e) {
            log.warn("타임아웃 주문 취소 스킵 (상태 경합): orderId={}, reason={}", orderId, e.getMessage());
        } catch (Exception e) {
            log.error("타임아웃 주문 취소 실패: orderId={}", orderId, e);
        }
    }
}
이 클래스는 세 가지 일을 맡습니다.
- 시간 컷오프 결정: 주문 생성 시각(
orderedAt)이 지금으로부터 15분보다 이전이면서 아직PAYMENT_REQUESTED인 주문을 찾습니다. - 건별 위임: 찾은 주문을 하나씩
OrderCommandService.cancelExpiredOrder()로 넘깁니다. - 실패 격리: 한 건이 실패해도 나머지 건은 계속 처리합니다.
스케줄러는 “재고 복구”나 “이벤트 발행” 같은 비즈니스 로직을 직접 가지지 않습니다. 그 책임은 OrderCommandService.cancelExpiredOrder() 로 위임되어 있습니다. 스케줄러는 “주기적으로 깨워서 후보를 찾는 트리거”의 역할만 합니다. 그래서 4-Layered 구조에서는 infrastructure 에 둡니다.
결제 실패와 결제 타임아웃은 같은 취소인가
겉으로 보면 둘 다 “주문을 CANCELLED로 만들고 재고를 복구한다”는 같은 일을 합니다. 주문 생성과 결제 실패 글을 따라온 입장에서 보면 결제 실패 글의 payment.failed 흐름을 그대로 재활용해도 되지 않을까 싶습니다. 그런데 PeekCart 는 굳이 별도의 진입점(cancelExpiredOrder)을 두었습니다. 차이를 정리해보면 왜 분리했는지가 드러납니다.
| 측면 | 결제 실패 | 결제 타임아웃 (이 글) |
|---|---|---|
| 트리거 | Toss 결제 콜백 또는 사용자 명시적 실패 | 스케줄러가 깨어났을 때 |
| 트리거 시점 | 결제 시도 직후 (수초~수분) | 주문 시작 15분 후, 그리고 그 이후 계속 |
| 컨텍스트 | 결제 요청 ID, 실패 사유 코드 등 외부에서 들어옴 | 외부 컨텍스트 없음. “오래됐다”는 사실만 있음 |
| 단건 vs 배치 | 단건 (한 결제 = 한 주문) | 배치 (여러 만료 주문을 한 번에 발견) |
| 실패 시 사용자 | 사용자가 화면에서 응답을 기다리고 있음 | 사용자 부재. 스케줄러만 결과를 봄 |
| 트랜잭션 경계 | 결제 요청 흐름의 일부 (자연스러운 단일 트랜잭션) | 건별 독립 트랜잭션이 강제됨 |
분리한 이유는 “단건 vs 배치”와 “트랜잭션 경계” 줄에 있습니다. 결제 실패는 “이 한 건”의 동기 흐름이라 트랜잭션 경계가 명확합니다. 반면 타임아웃은 “여러 건”이 한 번에 후보가 되고 한 건 실패가 다른 건에 영향을 주면 안 됩니다.
분리해서 얻는 또 다른 효과는 로그입니다. “결제 실패로 취소된 주문”과 “타임아웃으로 취소된 주문”은 운영자에게 다른 신호입니다. 전자는 결제 시스템의 문제 신호이고 후자는 사용자 이탈 신호입니다. 진입점이 다르니 로그 메시지도 따로 남습니다. 이 둘을 구분하는 메트릭은 아직 없습니다.
cancelExpiredOrder: REQUIRES_NEW 건별 트랜잭션
OrderCommandService.cancelExpiredOrder(Long) 는 이렇게 생겼습니다.
@Transactional(propagation = Propagation.REQUIRES_NEW)
public void cancelExpiredOrder(Long orderId) {
    MDC.put("orderId", orderId.toString());
    Order order = orderRepository.findById(orderId)
            .orElseThrow(() -> new OrderException(ErrorCode.ORD_001));

    order.cancel();

    for (var item : order.getOrderItems()) {
        productPort.restoreStock(item.getProductId(), item.getQuantity());
    }

    outboxEventPublisher.publishOrderCancelled(order);
}
Propagation.REQUIRES_NEW 가 붙어 있으므로 호출자(OrderTimeoutScheduler.cancelSafely)에서 트랜잭션이 열려 있든 없든, 이 메서드는 항상 새 트랜잭션을 시작합니다.
지금 코드에서 cancelExpiredOrders() 에는 @Transactional 이 없습니다. 그래서 기본 전파(REQUIRED)였더라도 호출마다 트랜잭션이 따로 열리고, 결과는 지금과 같습니다. REQUIRES_NEW 는 누군가 스케줄러 메서드에 @Transactional 을 붙이는 경우를 막는 방어입니다. 그런 변경이 들어오면 어떻게 되는지 시나리오로 보겠습니다.
스케줄러 트랜잭션 1개 안에서:
  - 주문 A 취소: 성공 (재고 복구, Outbox 저장)
  - 주문 B 취소: 성공 (재고 복구, Outbox 저장)
  - 주문 C 취소: 실패, RuntimeException

결과: 트랜잭션 전체 롤백
      주문 A, B 의 취소도 같이 사라짐
      다음 1분 뒤 스케줄러가 깨어나 A, B, C 를 다시 후보로 봄
      C 가 계속 실패하면 매 주기 같은 롤백이 반복됨
100건 중 99건이 멀쩡한데 1건의 데이터 이상 때문에 99건이 계속 못 풀리는 상황이 가능합니다. REQUIRES_NEW 는 호출자가 바뀌어도 이 시나리오가 생기지 않게 합니다. C의 실패는 C의 트랜잭션만 롤백시키고 A와 B의 커밋된 상태는 그대로 남습니다.
코드 첫 줄의 MDC.put("orderId", ...) 는 Phase 3에서 추가했습니다. 이후 이 스레드가 찍는 로그 라인에 orderId 가 따라붙어, 1분 주기로 여러 주문을 처리할 때 어느 로그가 어느 주문에 대한 것인지 구분할 수 있습니다. 다만 HTTP 요청을 처리하는 MdcFilter(관측성 글)와 달리 이 경로에는 MDC를 지우는 코드가 없습니다. 그래서 스케줄러 스레드에는 마지막으로 처리한 주문의 orderId 가 다음 주기의 로그까지 남습니다.
그래도 try-catch가 필요한 이유
REQUIRES_NEW 가 트랜잭션 격리는 해결하지만 예외 전파까지 막아주지는 않습니다. C 트랜잭션이 롤백되면서 던진 예외는 호출자(스케줄러)로 전달되고 스케줄러가 그걸 받아주지 않으면 for 루프가 중간에 깨집니다. C 이후의 D, E, F가 처리되지 않은 채 다음 주기를 기다리게 됩니다.
그래서 cancelSafely 는 두 단계로 처리합니다.
private void cancelSafely(Long orderId, String orderNumber) {
    try {
        orderCommandService.cancelExpiredOrder(orderId);
        log.info("타임아웃 주문 취소: orderId={}, orderNumber={}", orderId, orderNumber);
    } catch (OrderException e) {
        log.warn("타임아웃 주문 취소 스킵 (상태 경합): orderId={}, reason={}", orderId, e.getMessage());
    } catch (Exception e) {
        log.error("타임아웃 주문 취소 실패: orderId={}", orderId, e);
    }
}
OrderException 이 와도 다음 주문으로 넘어가는지는 단위 테스트로 확인합니다.
@Test
@DisplayName("상태 경합(OrderException)이 발생해도 나머지는 처리된다")
void cancelExpiredOrders_orderExceptionSkipsAndContinues() {
    // order1 처리 시 ORD-003 (잘못된 상태 전이) 발생
    willThrow(new OrderException(ErrorCode.ORD_003))
        .given(orderCommandService).cancelExpiredOrder(order1.getId());

    orderTimeoutScheduler.cancelExpiredOrders();

    // order2 는 정상 처리됨
    then(orderCommandService).should(times(1)).cancelExpiredOrder(order2.getId());
}
상태 경합(state race)이란 이런 상황입니다. 스케줄러가 findByStatusAndOrderedAtBefore 로 주문 A를 후보로 가져온 뒤, cancelExpiredOrder() 가 A를 다시 읽기 전에 Toss의 늦은 결제 콜백이 A를 PAYMENT_COMPLETED 로 바꾸고 커밋합니다. cancelExpiredOrder() 는 새 트랜잭션에서 A를 다시 읽으므로 바뀐 상태를 봅니다. 이때 Order.cancel() 의 상태 전이 가드가 OrderException(ORD_003) 을 던집니다. PAYMENT_COMPLETED 에서 CANCELLED 로 가는 전이는 허용되지 않기 때문입니다. 이건 정상 동작입니다. 결제는 이미 끝났으므로 취소하면 안 됩니다.
이 가드는 상대 쪽 커밋이 먼저 끝났을 때만 동작합니다. Order 엔티티에는 버전 컬럼이 없어서, 결제 콜백과 스케줄러가 거의 같은 순간에 둘 다 PAYMENT_REQUESTED 를 읽으면 두 쪽 모두 가드를 통과하고 나중에 커밋한 쪽의 상태가 남습니다. 지금 구현은 이 경우를 막지 않습니다.
WARN 로그로 남기고 다음 주문으로 넘어가는 게 정답입니다. 그래서 OrderException 은 WARN 으로 남기고 두 번째 catch(예상치 못한 예외)는 ERROR입니다. 같은 try-catch 안에서 로그 레벨을 분리하는 작은 결정에 “정상 동작인가 / 진짜 장애인가”를 가르는 운영 의도가 들어있습니다.
findByStatusAndOrderedAtBefore: 인덱스와 JOIN FETCH
스케줄러가 1분마다 실행한다는 건, 이 쿼리가 1분마다 한 번씩 돌아간다는 뜻입니다. 그리고 orders 테이블은 운영 환경에서 가장 빠르게 커지는 테이블 중 하나입니다. 인덱스가 없으면 풀스캔으로 시작됩니다.
@Query("SELECT o FROM Order o JOIN FETCH o.orderItems " +
       "WHERE o.status = :status AND o.orderedAt < :cutoff")
List<Order> findByStatusAndOrderedAtBefore(
        @Param("status") OrderStatus status,
        @Param("cutoff") LocalDateTime cutoff);
대응하는 인덱스는 V1__init_schema.sql 에 함께 정의되어 있습니다.
KEY idx_orders_status_ordered_at (status, ordered_at),복합 인덱스의 컬럼 순서가 (status, ordered_at) 이지 (ordered_at, status) 가 아니라는 점에 의도가 있습니다. 이 쿼리는 status 를 등치 조건으로, ordered_at 을 범위 조건으로 씁니다. 등치 조건 컬럼을 앞에 두면 status = 'PAYMENT_REQUESTED' 구간 안에서 ordered_at < cutoff 범위만 이어서 훑을 수 있습니다. 순서를 거꾸로 두면 ordered_at 범위에 걸린 모든 상태의 주문을 읽은 뒤 status 로 다시 걸러야 합니다.
JOIN FETCH 는 주문을 가져올 때 orderItems 까지 한 쿼리로 읽어 둡니다. 그런데 지금 호출 경로에서는 이 효과가 쓰이지 않습니다. 스케줄러는 가져온 주문에서 id 와 orderNumber 만 꺼내 넘기고, cancelExpiredOrder() 는 새 트랜잭션에서 findById() 로 주문을 다시 읽은 뒤 getOrderItems() 를 돕니다. 이때 주문마다 orderItems 를 읽는 쿼리가 따로 나갑니다. 스케줄러 쿼리의 JOIN FETCH 는 쓰지 않을 항목까지 읽는 셈이라, 빼거나 cancelExpiredOrder() 쪽 조회에 옮기는 편이 맞습니다.
이 쿼리는 페이징이 없다. “지금까지 만료된 모든 주문”을 한 번에 가져온다. 정상 운영에서는 한 주기에 잡히는 건수가 직전 1분 남짓 동안 새로 만료된 주문 수에 그친다는 가정에 기댄 선택이다. 주문 유입이 커지거나 실패 건이 쌓이면 LIMIT을 두는 페이지네이션이 필요해질 수 있다.
단일 인스턴스 가정과 그것이 깨질 때
지금까지 본 코드는 단일 JVM, 단일 Pod 환경에서 완벽하게 동작합니다. 1분마다 한 번 깨어나고 만료 주문을 모아서 건별로 안전하게 취소하고 다음 주기를 기다립니다.
문제는 Phase 3에서 HPA로 Pod 이 1에서 3으로 늘어나는 순간 발생합니다. 같은 @Scheduled 메서드가 세 Pod 에서 동시에 깨어납니다. 세 Pod 이 같은 쿼리로 같은 만료 주문 목록을 가져오고 같은 주문에 대해 동시에 cancelExpiredOrder() 를 호출합니다.
이 상황에서 무엇이 잘못될 수 있을까? 두 가지 안전장치가 이미 들어있습니다.
- 상태 전이 가드:
Order.cancel()은 현재 상태에서CANCELLED로의 전이가 허용되어 있을 때만 통과합니다. 첫 Pod 이 취소를 커밋한 뒤에 두 번째 Pod 이 주문을 읽으면, 두 번째 호출은OrderException(ORD-002 "이미 취소된 주문입니다.")로 막힙니다. 결제 콜백이 먼저 커밋해PAYMENT_COMPLETED로 전이된 경우라면ORD-003 "유효하지 않은 주문 상태 전이입니다."가 던져집니다. - 재고 복구의 낙관적 락: 두 Pod 이 거의 동시에 같은 주문을 읽으면 둘 다 상태 가드를 통과합니다. 이때는 재고(
Inventory) 엔티티의@Version이 막습니다. 두 트랜잭션이 같은 재고 행을 복구하려 하므로 늦게 커밋하는 쪽이 버전 충돌로 실패하고, 그 트랜잭션의 주문 취소와 Outbox 저장도 함께 롤백됩니다. 버전 충돌 예외는 두 번째catch로 가서ERROR로그로 남습니다.
그러니까 같은 주문의 재고가 두 번 복구되지는 않습니다. 다만 비효율은 남습니다. 세 Pod 이 같은 일을 시도하고 나머지 Pod 은 예외를 받아 로그를 찍습니다. Pod 이 3개라면 만료 주문 100건마다 200개의 불필요한 트랜잭션 시도(SELECT + 상태 검증)가 추가됩니다. 정합성은 상태 가드와 재고의 버전 검사가 지키지만, Pod 수에 비례해 늘어나는 중복 시도 자체가 운영상의 잡음이 됩니다.
정합성은 유지되지만 불필요한 시도는 남습니다. 그래서 Phase 2의 ShedLock 글에서 다룰 ShedLock 이 등장합니다. 코드 위쪽에 이미 보였던 한 줄이 그것입니다.
@SchedulerLock(name = "orderTimeoutCancelJob",
               lockAtMostFor = "PT10M", lockAtLeastFor = "PT30S")
ShedLock 은 DB 의 shedlock 테이블에 락 행을 INSERT/UPDATE해서 “지금 이 작업은 한 인스턴스만 들고 있다”는 사실을 보장합니다. lockAtMostFor 는 그 인스턴스가 죽었을 때 락이 풀리는 최대 시간이고 lockAtLeastFor 는 작업이 빨리 끝나더라도 최소한 이 시간 동안은 다른 인스턴스가 다시 잡지 못하게 막아줍니다. 후자가 왜 필요한지는 ShedLock 글에서 다룹니다.
여기서 짚을 점은 시간 순서입니다. 이 스케줄러는 Phase 1에서 ShedLock 없이 먼저 도입되었고, Phase 2에서 ShedLock이 덧붙여졌다. 다시 말해 코드 한 줄(@SchedulerLock)을 추가하는 작업이 Phase 2의 별도 태스크였습니다. 단일 인스턴스에서는 ShedLock 이 노옵이라 동작에 차이가 없지만 Phase 3 분산 환경에 진입할 때 추가 비용 없이 그대로 동작하게 하려는 의도입니다.
한계와 트레이드오프
컷오프 시점이 코드에 박혀 있다
LocalDateTime cutoff = LocalDateTime.now().minusMinutes(15);15분이라는 숫자가 메서드 안에 리터럴로 들어있습니다. Toss Payments 의 세션 만료 시간을 기준으로 잡았지만 결제 PSP 를 바꾸거나 결제 수단별로 다른 타임아웃을 두고 싶어지면 이 값을 외부화해야 합니다. 현재 범위에서는 yet-not-needed로 두는 게 맞지만 “어떤 값이 외부 시스템의 계약에 묶여 있는가”는 ADR 한 줄로라도 남겨둘 가치가 있습니다.
60초 주기의 의미
fixedDelay = 60_000 은 “이전 실행이 끝난 시점으로부터 60초 후”입니다. 만료 주문이 많아서 한 사이클이 3분 걸렸다면, 다음 사이클은 그로부터 60초 뒤입니다. fixedRate 를 썼다면 시작 시점 기준이라 사이클이 겹칠 수 있고 단일 인스턴스에서 같은 메서드가 중첩 실행되는 상황을 막기 위해서라도 fixedDelay 가 안전합니다.
15분 컷오프와 60초 주기 사이의 관계도 짚을 만합니다. 컷오프 기준은 주문 생성 시각(orderedAt)입니다. 주문 생성부터 실제 취소까지는 15분에 대기 60초, 그리고 앞 사이클의 실행 시간이 더해져 최대 16분 남짓이 걸립니다. 사용자에게는 충분히 빠르고, DB에는 60초마다 한 번씩만 쿼리하므로 가벼운 편입니다. 만약 컷오프를 1분으로 줄이면(예: 외부 마켓에서 카운트다운 결제) 주기도 비례해서 짧아져야 합니다.
”왜 안 취소됐는가”의 가시성
타임아웃 취소가 실패하면 ERROR 로그만, 스킵되면 WARN 로그만 남습니다. 운영자가 “이 주문은 왜 30분이 지나도 PAYMENT_REQUESTED인가”(매 주기 ERROR 로 실패하는 경우)를 추적하려면 로그를 뒤져야 합니다. Phase 3에서 메트릭을 붙인다면(관측성 글) scheduler.skip.count 같은 카운터가 있어도 좋습니다. 현재는 운영 규모상 로그로 충분하지만 분산 환경 + 다중 도메인 스케줄러가 늘어나면 메트릭이 필요해질 영역입니다.
의도적으로 안 한 것
- 사용자 통보: 자동 취소된 사용자에게 “결제가 완료되지 않아 주문이 취소되었습니다” 같은 알림 발송. 현재는
order.cancelled이벤트만 Outbox로 발행하고 알림 도메인이 그걸 받아 Slack으로 보내지만 사용자 직접 통보 채널(SMS/이메일)은 미구현. - 재시도 결제 유도: 만료 직전 “결제를 마저 진행할까?” 같은 푸시. 결제 이탈률을 줄이는 흔한 패턴이지만 현재 범위 외.
- 컷오프 시간 사용자/상품별 차등: 모든 주문이 일률적으로 15분.
단위 테스트로 검증한 것
OrderTimeoutSchedulerTest 는 OrderCommandService 를 mock 으로 둔 4건의 단위 테스트입니다.
- 만료 주문 2건이 있으면 각각
cancelExpiredOrder가 한 번씩 호출됩니다. - 만료 주문이 없으면
cancelExpiredOrder가 호출되지 않습니다. - 첫 번째 주문이
RuntimeException을 던져도 두 번째는 정상 처리됩니다 (예상치 못한 장애 격리). - 첫 번째 주문이
OrderException을 던져도 두 번째는 정상 처리됩니다 (상태 경합 격리).
(3)과 (4)는 예외 종류만 다른 같은 형태의 테스트입니다. 두 테스트가 확인하는 것은 “예외가 나도 다음 주문을 처리한다”는 점뿐이고, 로그 레벨은 검사하지 않습니다. 그래서 두 catch 를 catch (Exception e) 하나로 합쳐도 두 테스트는 그대로 통과합니다. WARN 과 ERROR 를 나눈 의도는 지금은 코드에만 남아 있습니다.
서비스 측에서는 OrderCommandServiceTest 에 cancelExpiredOrder 성공/주문 미존재(ORD-001) 2건이 있어, 스케줄러와 서비스를 각각 따로 검증합니다. 여러 Pod 이 같은 주문을 동시에 취소하는 상황은 테스트하지 않았습니다.
Phase 4 MSA에서는 어떻게 바뀌는가
타임아웃 스케줄러는 Phase 4에서 가장 자연스럽게 Order Service로 이동합니다. 핵심 데이터(orders.status, orders.ordered_at)가 Order Service 의 DB로 옮겨지고 스케줄러는 그 DB 를 1분마다 폴링하면 됩니다.
flowchart LR
    subgraph OrderService["Order Service"]
        Sched["OrderTimeoutScheduler"]
        OCS["OrderCommandService"]
        OrderDB["Order DB: orders, order_items"]
        Outbox["outbox_events"]
    end
    subgraph InventoryService["Inventory Service"]
        InvConsumer["InventoryEventConsumer"]
        InvDB["Inventory DB"]
    end
    Sched -->|1분 주기| OCS
    OCS -->|Order cancel| OrderDB
    OCS -->|order.cancelled INSERT| Outbox
    Outbox -.->|Kafka order.cancelled| InvConsumer
    InvConsumer -->|재고 +N| InvDB
그대로 가는 것
OrderTimeoutScheduler와cancelExpiredOrder()의 흐름은 거의 그대로 옮깁니다. 컷오프 결정, 후보 조회, 건별 위임, 실패 격리 순서입니다.REQUIRES_NEW+ try-catch 패턴, 그리고 그 의미는 변하지 않습니다. 오히려 서비스가 분리되면서 한 인스턴스의 트랜잭션 경계가 더 명확해집니다.- ShedLock 은 Phase 4에서도 그대로 유효합니다. Order Service 가 여러 Pod으로 뜨는 한 같은 문제가 남습니다.
바뀌는 것
- 재고 복구가 동기 메서드 호출에서 비동기 이벤트로 전환됩니다. 현재는
productPort.restoreStock()이 같은 트랜잭션 안에서 직접 호출되지만 서비스 분리 후에는OrderCancelledEvent를 Outbox 에 저장하고 Kafka로 Inventory Service 에 알리는 형태가 됩니다. 주문 생성과 결제 실패 글에서 본 결제 실패 시 재고 복구가 보상 트랜잭션(Saga) 단계로 바뀌는 흐름과 정확히 같습니다. - 이 비동기화는 “취소 발생부터 재고 실제 복구”까지의 지연을 만듭니다. 사용자 입장에서는 보이지 않지만 운영 모니터링에서는
order.cancelledKafka Lag 을 보고 있어야 재고가 제때 풀리고 있는지 확인할 수 있습니다. - Order Service 가 더 이상
Inventory의 데이터 모델을 알지 않습니다.OrderItem.productId와 수량만 이벤트에 실어 보내면, 재고를 어떻게 풀지는 Inventory Service 의 책임이 됩니다.
그래서 Phase 4 진입 전 짚을 점
- 스케줄러 자체는 분리하기 쉽습니다. 의존하는 외부 도메인이 사실상 재고(Inventory)뿐이고 그 호출은 이벤트로 대체 가능합니다.
- 주의해야 할 부분은 타임아웃 컷오프의 일관성입니다. Order Service 의 컷오프(15분)와 Payment Service 가 들고 있는 결제 세션 타임아웃이 어긋나면, “결제 세션은 살아있는데 주문은 이미 취소됨” 또는 그 반대의 상태가 만들어질 수 있습니다. 분리 후에는 두 서비스가 공유하는 계약 상수로 끌어내거나 ADR로 명시할 필요가 있습니다.
자료는 어떤 질문에 연결해서 읽을까
| 질문 | 같이 읽을 자료 | 이 글에서 연결되는 지점 |
|---|---|---|
Spring @Scheduled의 fixedDelay와 fixedRate, cron의 차이는? | Spring Framework 공식 문서, Task Execution and Scheduling | 60초 주기 선택의 의미 |
Propagation.REQUIRES_NEW는 정확히 어떻게 동작하는가? | Spring Framework 공식 문서, Transaction Propagation | 건별 독립 트랜잭션 절 |
| 결제 PSP의 세션 만료 정책은 어떻게 설계되는가? | Toss Payments 개발자 문서, 결제 위젯 가이드 | 15분 컷오프의 근거 |
| 배치 작업의 “건별 격리” 패턴은 어떤 책에서 다루는가? | Robert C. Martin, Clean Code, Error Handling 장 / Spring Batch 공식 문서의 skip/retry 정책 | cancelSafely의 try-catch 구조 |
| 다중 인스턴스 스케줄러 락 패턴 비교 (DB / Redis / ZooKeeper)? | ShedLock 공식 README, Distributed Lock Comparison | ”단일 인스턴스 가정과 그것이 깨질 때” 절 |
| 복합 인덱스 컬럼 순서 결정 기준? | High Performance MySQL (Schwartz et al.): Indexing for High Performance 장 | idx_orders_status_ordered_at의 컬럼 순서 |