PeekCart를 다시 학습하면서 개별 기술을 살펴보기 전에 프로젝트의 진행 순서를 확인하고 싶습니다.
Redis, Kafka, Kubernetes, MSA 같은 키워드가 많지만 이 기술들을 각각 따로 보면 왜 필요한지 잘 보이지 않습니다. 그래서 이 글에서는 코드를 깊게 보기 전에 전체 흐름을 먼저 정리하려고 합니다.
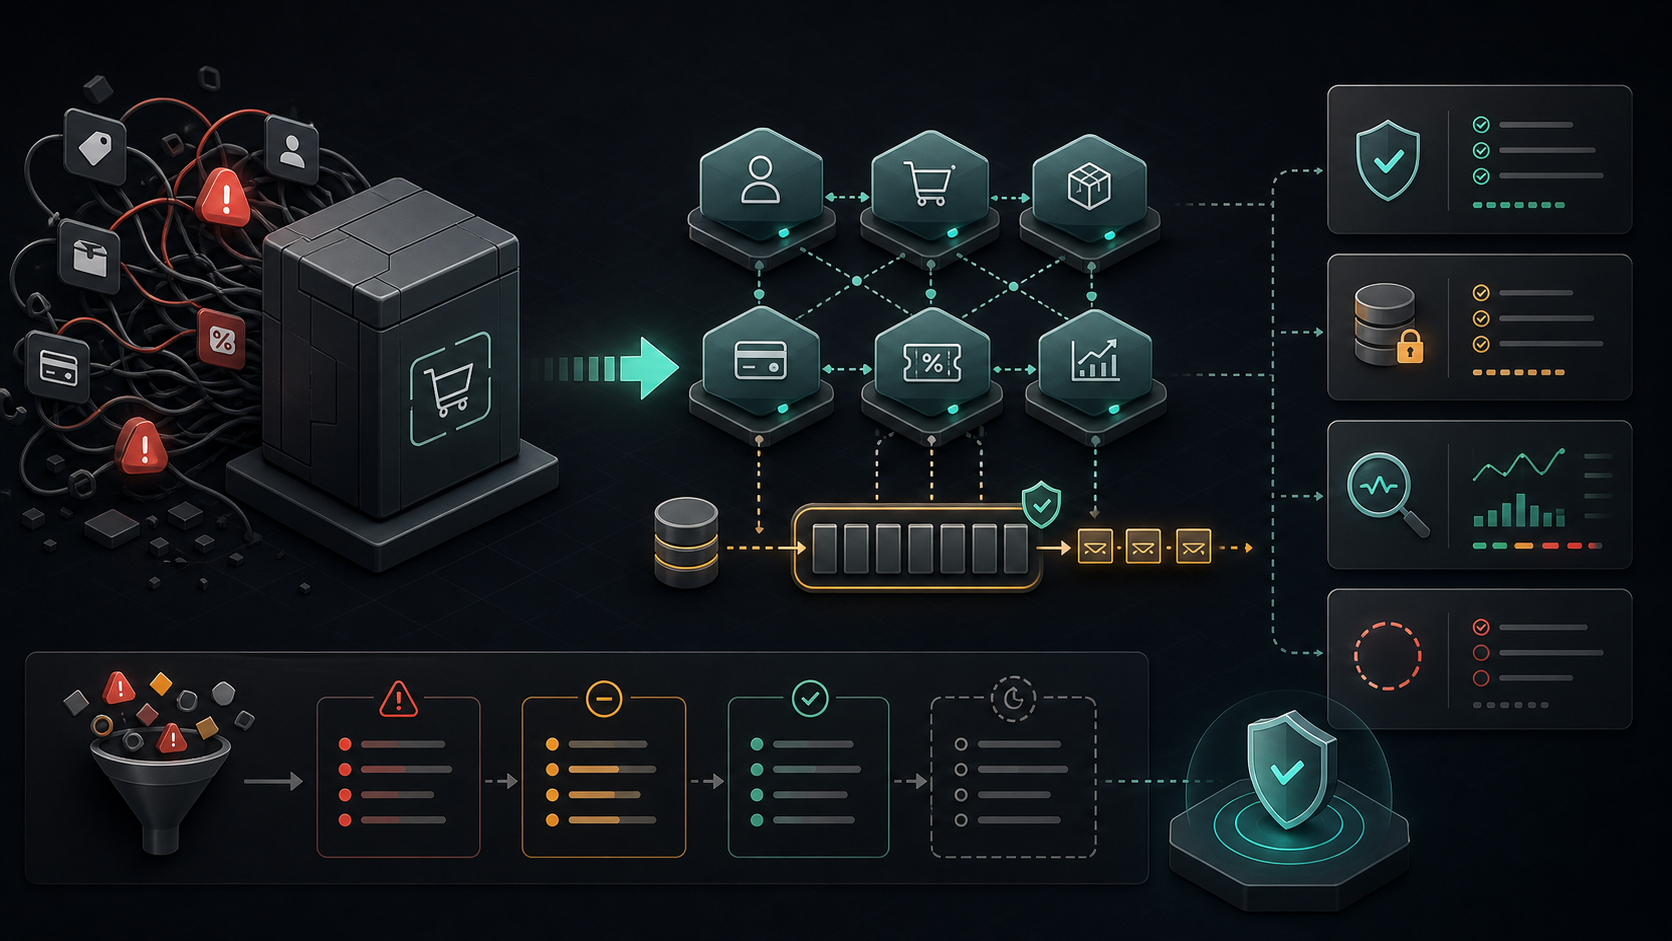
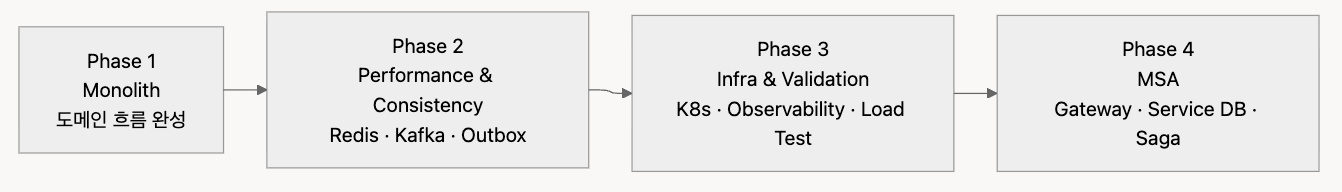
이 연재는 PeekCart를 네 단계로 진행했습니다. Phase 1은 단일 Spring Boot 모놀리스로 도메인을 구현한 단계, Phase 2는 캐시, 분산 락, Kafka와 Outbox로 성능과 정합성을 보강한 단계, Phase 3은 CI, Kubernetes, 관측성, 부하 테스트로 운영 환경을 검증한 단계, Phase 4는 서비스별로 나눈 MSA 단계입니다.
이번 학습에서는 PeekCart를 “MSA 프로젝트”로 바로 보지 않고 모놀리스에서 어떤 문제를 먼저 확인했고 그 문제들이 어떻게 Phase 4의 분리 근거가 되는지 따라가 보려고 합니다.
처음에 가정했던 프로젝트 상황
PeekCart는 대용량 트래픽 환경을 고려한 이커머스 플랫폼을 목표로 시작했습니다. 다만 처음부터 실제 대규모 서비스를 운영한다고 가정한 것은 아닙니다. 개인 포트폴리오 프로젝트라는 제약 안에서 이커머스에서 자주 문제가 되는 상황을 단계적으로 재현하고 학습하는 쪽에 가깝습니다.
초기에는 아래 상황을 가정했습니다.
- 사용자는 상품을 조회하고 장바구니에 담은 뒤 주문과 결제를 진행합니다.
- 상품 조회는 읽기 요청이 많고 같은 상품 목록과 상세 정보가 반복해서 조회됩니다.
- 인기 상품은 여러 사용자가 동시에 주문할 수 있고 이때 재고가 음수가 되면 안 됩니다.
- 주문 생성 이후 결제, 알림 같은 후속 처리는 주문 트랜잭션과 강하게 묶이면 장애 전파가 커질 수 있습니다.
- 결제 실패나 결제 타임아웃이 발생하면 주문 상태와 재고를 다시 맞춰야 합니다.
- 운영 환경에서는 애플리케이션이 한 대만 떠 있다고 볼 수 없고 스케줄러나 이벤트 발행도 중복 실행을 고려해야 합니다.
- 기능이 동작하는 것만으로는 충분하지 않고 실제 부하 상황에서 성능과 정합성을 관찰할 수 있어야 합니다.
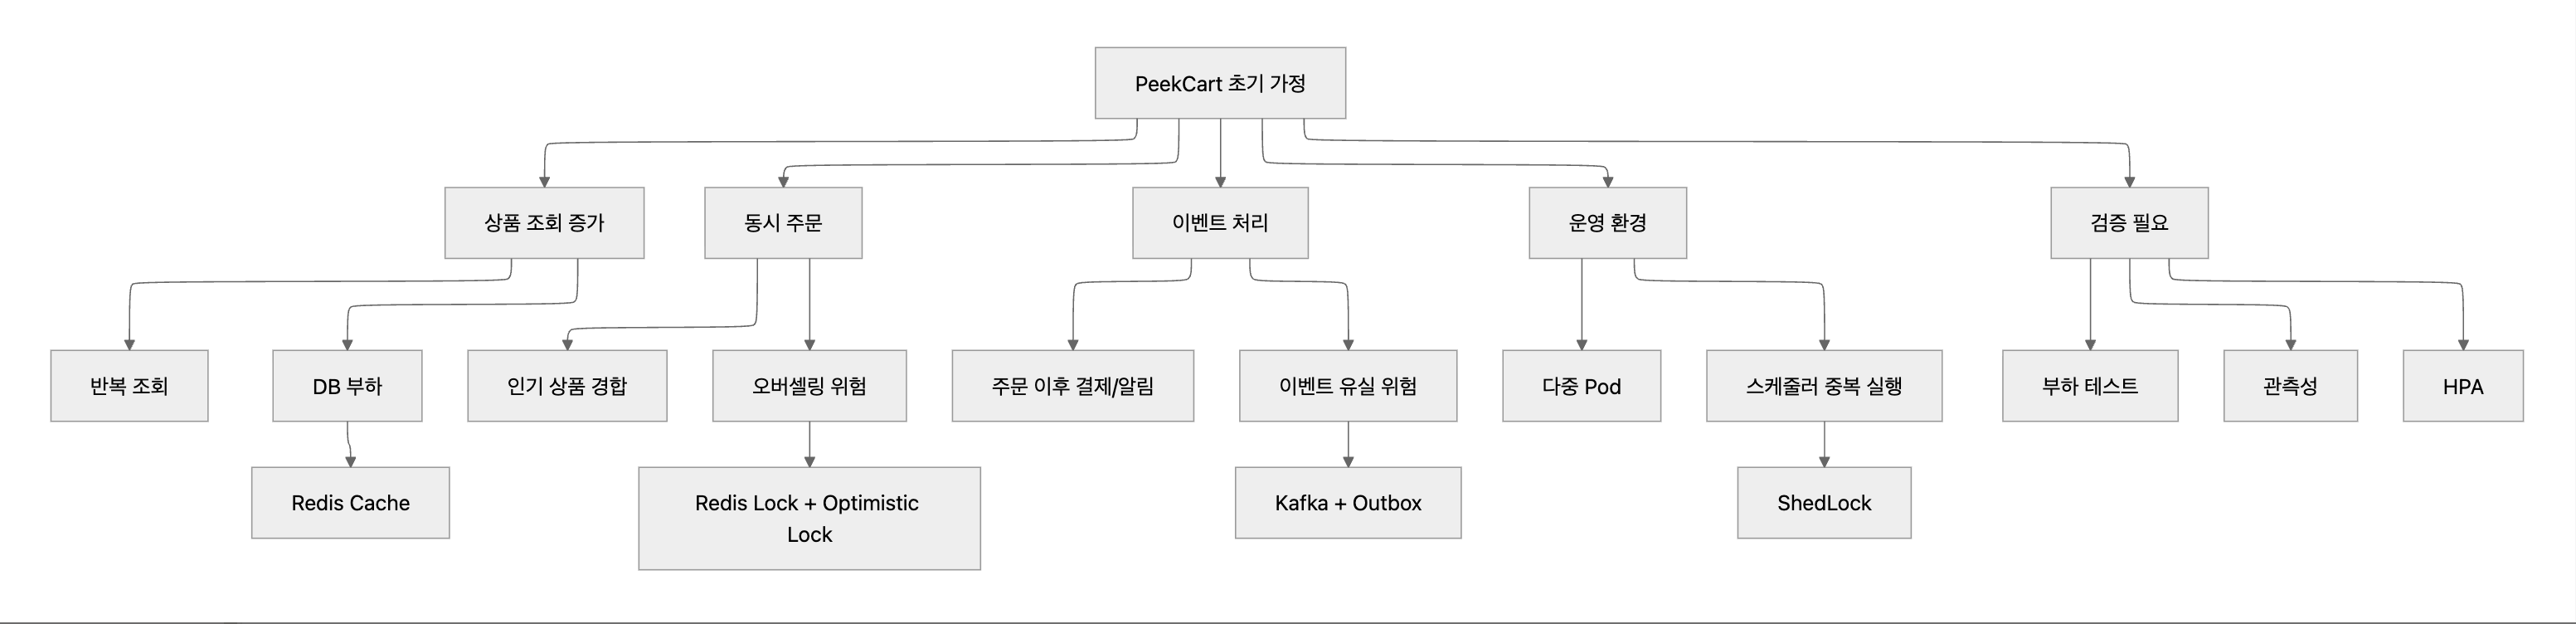
이 가정들을 놓고 보면 처음부터 MSA를 구현하기에 앞서 확인해야 할 것이 많습니다. 도메인 흐름이 어떻게 이어지는지, 재고 정합성은 어디서 깨질 수 있는지, 이벤트 처리 실패는 어떤 방식으로 복구해야 하는지부터 이해해야 합니다.
그래서 PeekCart는 처음에 단일 Spring Boot 애플리케이션으로 시작했습니다. 이유는 아래 “Phase 1은 왜 모놀리식이었을까”에서 봅니다.
이번 학습에서 확인하고 싶은 질문
이 글에서는 세 가지 질문을 살펴보려고 합니다.
- 왜 처음부터 MSA로 시작하지 않았을까요?
- Phase 1~3에서 어떤 문제를 먼저 해결했을까요?
- Phase 4에서 분리하려는 경계는 앞 단계에서 어떻게 드러났을까요?
이 질문을 따라 프로젝트를 읽으면 기술 스택을 용도와 함께 볼 수 있습니다. Redis는 캐시이면서 재고 동시성 제어의 도구이고, Kafka는 비동기 메시지 브로커이면서 Outbox와 함께 이벤트 유실을 줄이는 장치입니다. Kubernetes도 배포 도구로 쓰이면서 HPA와 관측성 검증의 전제가 됩니다.
Phase 1은 왜 모놀리식이었을까
처음부터 MSA로 시작하면 서비스 분리, DB 분리, 배포, 네트워크 통신, 장애 추적 같은 문제가 동시에 생깁니다. 아직 도메인 흐름도 충분히 검증되지 않았다면 서비스 경계를 나누는 것 자체가 추측에 가까워집니다.
그래서 Phase 1에서는 하나의 Spring Boot 애플리케이션 안에서 User, Product, Order, Payment, Notification 도메인을 먼저 구현했습니다. 이를 단순히 쉬운 길을 선택한 결과로 보기보다는 비즈니스 흐름과 도메인 경계를 먼저 관찰할 수 있는 형태를 선택한 것으로 이해하려고 합니다.
내부 구조에도 책임 구분을 두었습니다. 4-Layered + DDD 구조를 사용해 각 도메인의 Presentation, Application, Domain, Infrastructure 책임을 나눴습니다. 배포 단위는 하나지만 코드 안에서는 도메인 책임을 관찰할 수 있게 했습니다.
Phase 1에서 제가 확인해야 할 것은 “모놀리스냐 MSA냐”가 아닙니다. 도메인의 책임과 흐름을 아래 질문으로 살펴보려고 합니다.
- User, Product, Order, Payment, Notification은 각각 어떤 책임을 가질까?
- 주문 생성 시 어떤 도메인들이 함께 움직일까?
- 결제 실패나 타임아웃은 주문 상태와 재고에 어떤 영향을 줄까?
@TransactionalEventListener는 어디까지 편리하고 어디서 한계를 가질까?
이 질문들에 답할 수 있어야 Phase 4에서 서비스를 나눌 때도 패키지 구분에만 의존하지 않고 책임과 흐름을 기준으로 나눌 수 있습니다.
Phase 2는 어떤 불편함에서 출발했을까
Phase 1이 기능 흐름을 완성하는 단계였다면 Phase 2는 이커머스에서 바로 문제가 될 수 있는 부분을 보강하는 단계입니다.
상품 조회가 많아지면 DB 조회가 반복됩니다. 이 반복 조회에 Redis 캐싱을 적용합니다.
동시에 여러 사용자가 같은 상품을 주문하면 오버셀링이 생길 수 있습니다. 이를 막으려고 Redis 분산 락과 DB 낙관적 락을 함께 사용합니다.
주문 생성 후 결제나 알림 같은 후속 처리를 이벤트로 넘길 때 DB 저장과 이벤트 발행 사이에 실패가 생길 수 있습니다. 이 실패에 대응하려고 Kafka와 Outbox 패턴을 적용합니다.
Kafka를 사용하면 이벤트가 중복 소비될 수 있습니다. processed_events 테이블을 두고 Consumer 멱등성을 처리합니다.
Consumer 처리에 계속 실패하면 메시지를 버릴 수 없습니다. 그래서 DLQ와 Slack 알림을 둡니다.
스케줄러가 여러 Pod에서 동시에 실행될 수 있습니다. 이 중복 실행을 제어하려고 ShedLock을 적용합니다.
Phase 2의 기술들은 “성능 개선용 도구 모음”만으로 설명하기 어렵습니다. Phase 1에서 만든 도메인 흐름을 더 안전하게 만드는 보강책이기도 합니다.
Phase 2를 학습할 때는 각 기술의 사용법에 앞서 아래 질문을 먼저 봐야 합니다.
- 이 기술이 없을 때 어떤 장애나 데이터 불일치가 생길까?
- 이 기술은 문제를 완전히 없앨까, 아니면 특정 리스크를 줄일까?
- 남는 트레이드오프는 무엇일까?
- Phase 4에서 이 구조는 공통 모듈로 이동할 것일까, 서비스별로 복제될 것일까?
Phase 3는 왜 필요한가
Phase 2까지는 애플리케이션 내부의 설계와 정합성에 초점을 둡니다.
실제 운영에 가까워지려면 배포, 모니터링, 부하 테스트도 필요합니다. 기능 테스트가 통과한다고 해서 부하 상황에서 성능이 충분하거나 HPA가 의도대로 동작하거나 Kafka Consumer Lag이 안정적으로 돌아온다고 말할 수는 없습니다.
Phase 3에서는 Kubernetes 배포 구조를 만들고 Prometheus와 Grafana로 메트릭을 수집하고 nGrinder와 k6로 부하 테스트를 수행했습니다.
Phase 3에서 실제로 확인한 항목은 아래와 같습니다.
- 캐시 적용 전후 TPS가 어떻게 달라졌을까?
- 동시 주문에서 오버셀링이 발생하지 않았을까?
- HPA가 부하 상황에서 Pod를 늘렸을까?
- Kafka Consumer Lag이 peak 이후 정상 상태로 돌아왔을까?
- 관측성 설정이 여러 파일에 흩어졌을 때 어떤 회귀 위험이 생겼을까?
Phase 3는 Phase 4로 가기 전에 현재 구조의 성능과 운영 특성을 관찰하는 단계라고 볼 수 있습니다.
특히 부하 테스트 결과는 성공과 실패를 함께 봐야 합니다. 예를 들어 캐시 적용 후 TPS는 개선되었지만 목표였던 3배에는 미달했습니다. 동시 주문에서도 오버셀링은 0건이었지만 1,000 VUser 부하에서 HTTP failure는 높았습니다. 이 결과는 다음 학습 질문을 만드는 데이터로 남겼습니다.
- 병목은 CPU일까, DB 커넥션일까, Redis 락 contention일까?
- HPA는 어느 정도까지 도움을 주고 어느 지점부터는 한계가 있을까?
- Phase 4에서 Order Service를 분리하면 어떤 병목을 더 명확하게 관찰할 수 있을까?
기술마다 먼저 확인할 질문
회원, 상품, 주문, 결제를 CRUD로 구현하고 트래픽 증가 상황에서 성능과 정합성을 어떻게 지킬지까지 다룹니다.
기술 스택을 나열하는 것만으로는 이 목표를 설명하기 어렵습니다. Java, Spring Boot, Redis, Kafka, Kubernetes를 쓴다는 사실에 더해 각 기술이 어느 시점의 문제를 해결하려고 들어왔는지를 살펴봅니다.
Phase 1~3에서 쓴 각 기술과 구조에는 아래 질문을 연결할 수 있습니다.
| 기술 / 구조 | 먼저 확인할 질문 |
|---|---|
| 4-Layered + DDD | 모놀리스 안에서 도메인 책임을 어떻게 분리했는가? |
| Redis Cache | 반복 조회가 많은 상품 API에서 DB 부하를 어떻게 줄였는가? |
| Redis Lock + DB Optimistic Lock | 동시 주문에서 오버셀링을 어떻게 막았는가? |
| Kafka + Outbox | DB 저장과 이벤트 발행 사이의 실패를 어떻게 다뤘는가? |
| processed_events | 중복 이벤트 소비를 어떻게 안전하게 처리했는가? |
| ShedLock | 여러 Pod에서 스케줄러가 동시에 실행되는 문제를 어떻게 막았는가? |
| Kubernetes / HPA | 부하가 올라갈 때 애플리케이션이 어떻게 확장되는지 확인했는가? |
| Prometheus / Grafana | 성능과 장애 징후를 어떤 지표로 관찰했는가? |
이 표처럼 PeekCart에서는 문제와 해결책을 연결해서 봅니다.
Phase 4는 무엇을 바꾸는 단계인가
Phase 4의 작업 범위는 폴더 구분에만 머물지 않습니다.
지금까지 하나의 애플리케이션과 하나의 DB 안에 있던 경계를 서비스와 DB 단위로 분리하는 단계입니다.
서비스와 DB를 나누면 아래 질문들이 생깁니다.
- Order Service는 Product 정보를 어떻게 조회할까요?
- Payment 실패 시 Order와 Product의 상태는 어떻게 맞출까요?
- Gateway는 인증을 어디까지 책임질까요?
- 서비스별 DB로 나뉘면 FK 없이 정합성을 어떻게 지킬까요?
- 각 서비스의 관측성 설정은 어디에 위치해야 할까요?
- Outbox, idempotency, event DTO는 공통 모듈에 둘 수 있을까요?
이 질문들은 Phase 4에서 갑자기 생긴 것이 아닙니다. Phase 1~3에서 이미 Order, Product, Payment, Notification의 책임이 나뉘었고 Kafka와 Outbox, 멱등성, 관측성 계약이 준비되었기 때문에 Phase 4에서 본격적으로 다루게 됩니다.
그래서 Phase 4를 공부하기 전에 Phase 1~3을 복습하는 것은 단순한 과거 회고가 아닙니다. 서비스 경계를 왜 그렇게 나누려는지 이해하기 위한 준비 과정입니다.
이번 학습의 방향
앞으로는 기술을 각각 따로 떼어 학습하지 않으려고 합니다. 각 Phase에서 어떤 문제가 있었고 그 문제를 해결하려고 어떤 설계가 들어왔는지 아래 순서대로 따라가려고 합니다.
- Phase 1에서 도메인 모델과 기본 비즈니스 흐름을 이해합니다.
- Phase 2에서 성능, 정합성, 이벤트 처리 보강을 이해합니다.
- Phase 3에서 운영 환경과 부하 테스트 결과를 이해합니다.
- 마지막으로 Phase 4에서 어떤 경계를 기준으로 MSA를 분리할지 다시 봅니다.
이번 글은 이 학습의 시작으로, 개별 구현을 보기 전에 PeekCart가 왜 모놀리스에서 시작해 MSA로 가는 흐름을 갖게 되었는지 먼저 이해하려고 합니다.
다음 글에서 볼 것
다음 글에서는 4-Layered + DDD 구조를 먼저 볼 예정입니다.
Phase 1은 모놀리스였지만 내부는 책임별로 나뉘어 있었습니다. 각 도메인이 Presentation, Application, Domain, Infrastructure로 나뉘어 있고 비즈니스 규칙은 Domain 쪽에 모이도록 설계되어 있습니다.
다음 글에서는 아래 질문을 살펴봅니다.
- 왜 전통적인 Controller-Service-Repository 구조가 아니라 4-Layered + DDD 구조를 선택했을까요?
- Application Service와 Domain Entity는 어떤 책임을 나눠 가질까?
- JPA Entity를 Domain Entity로 함께 쓰는 절충안은 어떤 장단점이 있을까?
- 이 구조가 Phase 4 서비스 분리의 준비가 될 수 있을까?