다섯 서비스가 같은 비밀키를 들고 있었습니다
PeekCart를 다섯 서비스로 나눈 뒤에도 로그인 토큰은 각 서비스에서 검증하도록 두었습니다. user-service가 HS512로 JWT를 발급하면, 요청을 받은 서비스가 공용 인증 모듈의 JwtFilter로 서명을 검증하고 Redis의 로그아웃 목록을 확인했습니다. Redis 조회가 실패해도 통과시키지 않고 거절하는 fail-closed 방식이었습니다.
게이트웨이가 없는 동안 각 서비스가 스스로 검증하도록 한 것은 의도한 전환기 구조였습니다. 다만 HS512는 같은 비밀키로 서명과 검증을 하는 대칭키 방식입니다. 토큰을 발급하지 않는 네 서비스도 토큰을 만들 수 있는 키를 가지고 있었습니다. 이 배치에서는 어느 한 곳의 키가 유출돼도 다른 사용자의 토큰을 만들 수 있습니다.
키 하나가 새면, 위조 토큰을 누가 받아 줄까요?
서비스 하나를 골라 키를 유출시켜 보세요. 공격자가 그 키로 만든 토큰을 다섯 서비스에 보냅니다. 그다음 RS256으로 바꾸고 같은 서비스를 다시 털어 보세요.
키 유출은 비교를 위해 가정한 상황이며 실제로 일어난 사고가 아닙니다. 위조 토큰은 만료 시간이 유효하고 로그아웃 목록에도 없다고 가정했습니다. 전환 기간에 옛 HS512 토큰을 받아 주는 선택적 이중 검증, kid를 이용한 키 회전은 그리지 않았습니다. 이 단계에는 아직 게이트웨이가 없어 다섯 서비스가 각자 검증합니다.
같은 문자열을 Kubernetes Secret 다섯 개에도 넣었고, 환경별 설정에서도 바꾸지 않았습니다. 그래서 Kubernetes에 배포할 때도 저장소에 적힌 문자열을 그대로 서명 키로 쓰고 있었습니다.
키 말고도 바꿀 곳이 두 군데 더 있었습니다.
- minikube에서는 NodePort 30081부터 30085까지, GKE에서는 서비스별 Internal LoadBalancer로 서비스마다 바로 들어갈 수 있는 입구가 있었습니다.
- 사용한 refresh token을 지웠습니다. access token을 갱신할 때 쓰는 refresh token은 사용하면 행을 삭제했습니다. 그래서 훔친 옛 토큰이 다시 와도 “이미 쓴 토큰의 재사용”이라는 신호를 구분할 기록이 없었습니다.
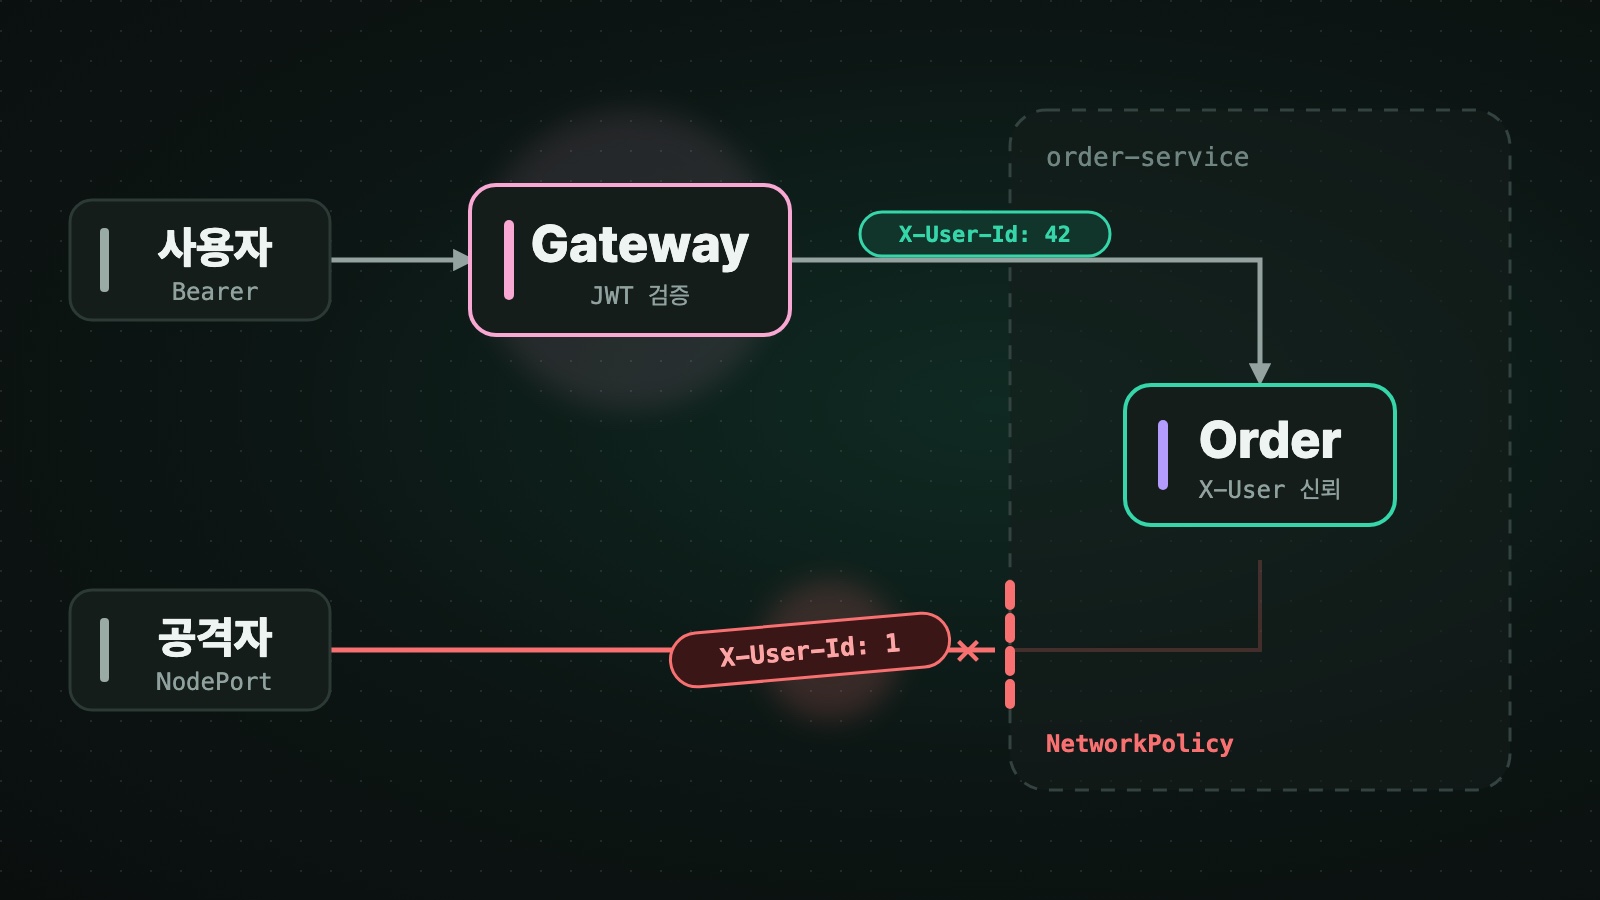
이 구조를 바꾸기 위해 게이트웨이를 두려고 했습니다. 목표는 게이트웨이가 토큰을 검증하고, 서비스는 게이트웨이가 넣은 사용자 정보 헤더를 믿으며, 우회 경로는 막는 것이었습니다. 다섯 서비스가 키를 나눠 가진 문제를 줄이면서, 게이트웨이가 인증을 맡는 구조도 직접 만들어 보고 싶었습니다. 실제 사용자 트래픽은 없었고, 무중단 롤아웃과 역순 롤백은 운영을 가정한 연습으로 설계했습니다.
문제는 도착점보다 거기까지 가는 순서였습니다. 서비스마다 하던 검증을 게이트웨이 하나로 옮기려면, 무엇을 어떤 순서로 바꿔야 할까요?
게이트웨이보다 먼저 바꿀 것
서비스가 사용자 헤더를 믿게 하려면, 검증 위치뿐 아니라 그 앞뒤 조건도 바꿔야 했습니다. 그래서 다음 네 가지를 함께 계획했습니다.
- 서명 키를 user-service에만 둡니다. HS512를 RS256 비대칭키로 바꾸고, 검증하는 쪽은 공개키만 받습니다.
- 사용한 refresh token의 상태를 남깁니다. 지우는 대신
ROTATED로 표시해 재사용을 감지하고, 같은 로그인에서 이어진 토큰 묶음(family) 전체를 막습니다. - 게이트웨이가 검증을 맡습니다. 검증을 마치면
X-User-Id,X-User-Role을 넣어 서비스로 전달하고, 외부에서 받은 같은 이름의 헤더는 항상 제거합니다. - 우회 경로를 닫습니다. 서비스가 헤더를 믿으려면 그 헤더를 넣을 수 있는 주체부터 제한해야 합니다.
먼저 서명 방식을 RS256으로 바꾸고, refresh token 재사용 감지를 구현한 뒤 게이트웨이를 붙이기로 했습니다. 인증 실패를 관찰할 지표와 옛 알고리즘 제거는 그 뒤에 두었습니다. 서명 방식을 먼저 바꾸려던 의도는 이랬습니다.
“이렇게 하면 나중에 Gateway가 중앙에서 토큰을 검증하고 내부 서비스는 헤더만 신뢰하는 구조로 자연스럽게 넘어갈 수 있다.”
앞의 두 변경은 서비스 내부 검증을 유지하면서도 적용할 수 있었습니다. 게이트웨이가 없어도 개인키를 user-service에만 남길 수 있고, 재사용 감지와 family 차단을 시작할 수 있는 순서였습니다.
돌아보면 재사용 감지를 먼저 만든 순서는 게이트웨이가 읽을 family 차단 표시를 미리 준비한 셈이 됐습니다. 처음부터 그렇게 의도한 것은 아닙니다. 구현할 때는 기존 JwtFilter에 차단 표시를 읽는 기능을 붙였고, 게이트웨이를 만들면서 그 책임을 옮겼습니다.
서명 키는 user-service에만 둡니다
RS256에서는 user-service만 개인키로 서명합니다. 공개키 목록은 JSON 형식인 JWKS로 /.well-known/jwks.json에서 제공하고, 토큰 헤더의 kid로 어느 공개키로 검증할지 고릅니다. 공개키만으로는 새 토큰을 서명할 수 없습니다.
이때 선택 기준은 검증하는 서비스에 서명 권한을 주지 않으면서 키를 교체하기 쉽게 만드는 것이었습니다. 대칭키를 유지하면 키 공유 문제도 남으므로 비대칭키로 바꾸고, ES256보다는 생태계 호환성이 넓은 RS256을 택했습니다. 공개키를 파일로 배포하면 키를 교체할 때 서비스도 다시 배포해야 하므로 JWKS로 제공했습니다.
외부 키 관리 서비스인 Cloud KMS에 서명을 맡기는 방법은 성능 등을 확인한 뒤 다시 검토하기로 했고, Vault를 운영하는 부담도 당장 추가하지 않았습니다. 게이트웨이를 둔 뒤에도 서비스마다 토큰을 재검증할 수는 있습니다. 다만 우회 경로를 닫는 구조에서 같은 검증을 반복하지 않기로 했습니다.
이미 발급한 토큰은 기다립니다
기존 구현에서는 HS512를 쓰고 있었습니다. 옛 토큰을 받아 줄 코드는 실제 알고리즘에 맞춰야 했습니다. 전환 시점에는 HS512 access token이 사용자 손에 남아 있을 수 있으므로 이중 검증 기간을 두었습니다.
- 새 토큰 발급은 RS256으로 바꿉니다.
- RS256 토큰은
kid로 공개키를 골라 검증합니다. - 옛 토큰은 별도 설정을 켰을 때 정확히 HS512만 허용합니다. 기본값은 꺼짐이며 마무리 단계에서 코드를 제거할 계획입니다.
당시 설정의 access token 수명은 30분이었습니다. HS512 발급을 멈추면 30분 안에 남은 옛 토큰이 모두 만료됩니다.
재사용 감지는 상태를 남깁니다
같은 로그인에서 이어진 refresh token 묶음을 family라고 부르고 family_id로 연결합니다. 각 토큰은 ACTIVE, ROTATED, REVOKED 상태로 관리합니다. 유예 시간은 정상적인 동시 요청을 수용하려고 이미 사용한 토큰을 짧게 한 번 더 받아 주는 시간이며, 당시 구현은 10초였습니다.
| 상황 | 처리 |
|---|---|
ACTIVE 토큰으로 refresh | 새 토큰을 발급하고 옛 토큰은 유예 시간이 있는 ROTATED로 바꿉니다. |
| 유예 시간 안에 같은 토큰이 다시 옴 | 한 번만 허용하고, 먼저 발급했던 새 refresh token은 유예 없이 ROTATED로 바꿉니다. |
유예가 끝났거나 소진된 토큰, REVOKED 토큰이 옴 | 재사용으로 판단해 family 전체를 REVOKED로 바꾸고 Redis에 auth:deny:family:<id>를 기록합니다. |
공격자가 먼저 갱신했다면, 누가 알아챌 수 있을까요?
같은 탈취 시나리오를 두 저장 방식으로 재생합니다. 단계를 누르거나 방식을 바꿔 보세요. 차이는 넷째 단계, 사용자가 옛 토큰을 다시 내미는 순간에 갈립니다.
탈취 시나리오는 재사용 감지가 무엇을 바꾸는지 보이려고 꾸민 예시입니다. 유예 시간 안에 같은 토큰이 다시 오는 경로(한 번 허용하고 먼저 발급한 토큰을 강제 회전), 사용자 쪽 access token, Redis 기록이 실패하는 경우는 그리지 않았습니다. 기존 방식의 401은 행을 찾지 못했을 때의 설명용 판정입니다.
Redis 차단 표시가 있으면 이미 발급한 access token도 막힙니다. 공격자와 실제 사용자 중 어느 쪽인지 구분하지 못하므로 둘 다 로그아웃되고, 실제 사용자는 다시 로그인해야 합니다.
이 동작을 구현하면서 트랜잭션 경계도 바꿨습니다. 요청은 거절하되 family 무효화는 커밋해야 했습니다. 처음에는 REQUIRES_NEW로 무효화를 분리했지만, 바깥 트랜잭션의 행 락을 안쪽 트랜잭션이 기다리는 자기 교착이 통합 테스트에서 발생했습니다. 재사용 전용 예외를 두고 noRollbackFor로 해당 예외에서만 커밋하도록 바꿨습니다. 재사용으로 들어가는 세 경로는 detectReuse로 모았습니다.
동시 요청은 조건부 벌크 UPDATE의 영향받은 행 수로 상태 전이 성공을 판정했습니다. 병렬 요청 두 개 중 하나만 전이에 성공하는지 Testcontainers MySQL로 확인했습니다. Redis 차단 기록 실패는 별도로 처리해 DB의 family 무효화가 롤백되지 않게 했습니다. 다만 차단 표시가 빠진 access token은 수명인 30분까지 남을 수 있습니다.
순서를 틀리면 어디서 막힐까요?
401과 위조 사이
첫 게이트웨이 계획은 검증 후 Authorization을 지우고 X-User-*를 넣는 구조였습니다. 그런데 기존 서비스는 Authorization의 Bearer 토큰만 읽습니다. 이 두 동작을 어느 쪽부터 배포하느냐에 따라 결과가 달라집니다.
세 가지 변경, 어떤 순서로 배포할까요?
세 변경을 원하는 순서대로 눌러 보세요. 하나를 배포할 때마다 정상 요청과 위조 요청이 한 번씩 지나갑니다. 여섯 가지 순서 중 중간에 아무것도 깨지지 않는 순서는 하나뿐입니다.
서비스 하나(Order)와 요청 두 개로 줄인 모형입니다. 출발 상태는 글의 ‘검증 병행’으로, 게이트웨이가 검증한 뒤 Authorization도 함께 넘깁니다. ‘토큰 빼기’는 글에서 아직 실행하지 않은 계획 단계이고, 옛 검증기 제거와 함께 묶여 있습니다. 입구를 닫으면 NetworkPolicy가 실제로 강제된다고 가정했고, Prometheus 허용 경로와 옛·새 Pod가 섞이는 과정은 그리지 않았습니다. 200·401 같은 결과는 설명용 판정입니다.
게이트웨이가 토큰을 먼저 빼면, Bearer만 읽는 기존 서비스가 게이트웨이를 거친 정상 요청을 401로 거절합니다. 서비스가 헤더를 먼저 믿으면, NodePort가 열려 있는 동안 X-User-Id: 1을 직접 붙인 요청이 다른 사용자로 인증될 수 있습니다.
배포 순서를 따져 보니, 게이트웨이와 서비스를 각각 고치는 것만으로는 이 틈을 메울 수 없었습니다. 게이트웨이 배포, 트래픽 전환, 입구 차단, 서비스 전환, 옛 검증 제거를 순서대로 해야 했습니다.
이미지도 나눠야 했습니다. 헤더 신뢰 전환과 옛 검증 제거를 하나의 이미지로 묶으면 따로 배포하거나 한 단계만 되돌릴 수 없습니다. 옛 검증기로 돌아가려면 게이트웨이가 먼저 Authorization을 다시 전달해야 합니다. 순서대로 배포하고 되돌리려면, 각 시점의 코드를 별도 이미지로 남겨야 했습니다.
공용 검증기를 그대로 쓸 수 없었습니다
Spring Cloud Gateway는 WebFlux 기반인데, 공용 모듈 :common은 servlet 기반 spring-boot-starter-web, JPA, Kafka를 api 의존성으로 노출하고 있었습니다. 이를 게이트웨이에 연결하면 MVC가 클래스패스에 들어와 게이트웨이가 MVC 애플리케이션으로 부팅됩니다.
그래서 검증기를 게이트웨이 안에 다시 만들어야 했습니다. 알고리즘 허용 목록, kid 선택, 클레임 해석, Redis 키 규칙을 두 곳에서 구현하는 비용이 생겼습니다. 두 구현의 판정이 다르면 전환 중 요청 경로에 따라 인증 결과가 달라질 수 있습니다. 실제로 차이가 난 사례를 본 것은 아니지만, 같은 토큰에 같은 결과를 내는지 검사하기 전에는 두 구현이 같다고 볼 수 없었습니다.
기본 rate limiter는 장애 때 요청을 통과시켰습니다
설계는 요청 횟수 제한에 쓰는 Redis가 실패해도 fail-closed로 거절하도록 했습니다. 그러나 프로젝트에서 사용한 Spring Cloud Gateway 4.3.0의 기본 RedisRateLimiter는 오류를 기록하고 요청을 허용했습니다.
// RedisRateLimiter#isAllowed의 Redis 오류 처리
return flux.onErrorResume(throwable -> {
    log.error("Error calling rate limiter lua", throwable);
    return Flux.just(Arrays.asList(1L, -1L)); // 첫 값 1 = allowed
})
게이트웨이 코드를 검토하다 이 동작을 확인했습니다. 기본 부품을 연결하는 것만으로는 의도한 장애 처리가 되지 않았습니다. deny-empty-key는 키 계산 결과가 비었을 때의 옵션이므로 Redis 장애 처리에는 쓸 수 없었습니다. (해당 버전 소스)
점진적으로 옮길 트래픽이 없었습니다
처음에는 일부 요청만 게이트웨이로 보내고 오류율을 보며 비중을 늘리는 canary 방식을 생각했습니다. 하지만 PeekCart에는 상시 클러스터도 실제 사용자 트래픽도 없었습니다. GKE는 측정하거나 검증할 때 띄웠다가 지우고 있었으므로, 점진적으로 옮길 대상부터 없는 셈이었습니다.
배포와 신뢰 전환을 나눴습니다
단계별 이미지와 롤백
처음에는 게이트웨이와 서비스의 인증 코드를 한 번에 바꾸려고 했습니다. 하지만 정상 요청을 계속 처리하면서 되돌릴 길도 남기려면, 검증을 추가하는 일과 기존 검증을 없애는 일을 분리해야 했습니다. 그래서 각 상태를 별도 이미지로 만들어 다음 순서로 배포할 수 있게 했습니다.
| 순서 | 바꾸는 것 | 문제가 생겼을 때 |
|---|---|---|
| 검증 병행 | 게이트웨이가 검증하되 Authorization도 전달합니다. 기존 서비스는 Bearer 검증을 유지합니다. | 게이트웨이로 보내던 요청을 우회 경로로 되돌립니다. |
| 배포 준비 | 게이트웨이의 Kubernetes 설정과 외부 노출 검사를 만듭니다. 이 작업에서는 실제 트래픽을 옮기지 못했습니다. | 게이트웨이 리소스만 이름으로 골라 삭제합니다. |
| 입구 차단 후 헤더 신뢰 | ClusterIP와 NetworkPolicy를 먼저 적용한 뒤 헤더를 믿는 서비스 이미지를 배포합니다. Authorization 전달은 유지합니다. | 먼저 이전 서비스 이미지로 되돌린 뒤 우회 경로 설정을 복구합니다. |
| 기존 검증 제거 | 실제 클러스터에서 입구 차단을 확인한 뒤 토큰 전달과 서비스의 옛 검증기를 제거할 계획입니다. | 토큰 전달을 먼저 복구하고 서비스를 옛 이미지로 되돌려야 합니다. |
여기서 구현한 범위는 입구 차단 설정과 헤더 신뢰 필터까지입니다. 실제 클러스터에서 검증하기 전에는 마지막 제거 작업으로 넘어가지 않기로 했습니다.
서비스를 헤더 신뢰 방식으로 바꿀 때는 입구 차단부터 적용하도록 순서를 고정했습니다. 그동안 서비스는 아직 Bearer를 검증하는 옛 이미지이므로 위조한 사용자 헤더만으로 인증되지 않습니다.
이 전환 중에는 옛 Pod와 새 Pod가 섞일 수 있습니다. 게이트웨이가 Authorization과 사용자 헤더를 함께 보내면 옛 Pod는 토큰을, 새 Pod는 헤더를 읽습니다. 새 이미지에서 문제가 생겨도 옛 이미지가 읽을 토큰은 계속 도착합니다. 그래서 서비스 전환이 끝날 때까지 토큰 전달을 유지하도록 했습니다.
배포 준비를 되돌릴 때도 삭제 범위를 좁혔습니다. 전체 구성에 kubectl delete -k를 실행하면 서비스까지 함께 지울 수 있으므로, 게이트웨이 리소스만 이름으로 골라 삭제하도록 했습니다. 롤아웃 공통 설정은 준비된 Pod 수가 줄지 않도록 maxUnavailable: 0으로 두었습니다.
입구 차단은 라벨과 포트로 표현합니다
Service는 클러스터 내부 주소만 쓰는 ClusterIP로 바꾸고, Pod 사이에 허용할 통신은 NetworkPolicy로 정했습니다. 처음에는 게이트웨이의 ServiceAccount를 기준으로 허용하려 했습니다. 하지만 Kubernetes 기본 NetworkPolicy는 상대를 ServiceAccount로 선택하지 못하므로 Pod 라벨을 썼습니다.
- 대상은
app.kubernetes.io/component: backend가 붙은 서비스 Pod입니다. - 같은 네임스페이스의
app: gatewayPod와, monitoring 네임스페이스의app.kubernetes.io/name: prometheusPod를 허용합니다. - 허용 포트는 TCP 8080이며, 정책 방향은
Ingress입니다.
Prometheus 경로도 허용하므로 정책을 읽을 때는 “게이트웨이만 허용”이라는 요약보다 실제 허용 상대와 포트를 확인해야 합니다.
검증 코드는 나누되 동작은 같아야 합니다
게이트웨이에는 전용 검증기와 응답 DTO를 두었습니다. 게이트웨이도 서명과 만료를 확인한 뒤 Redis의 로그아웃 목록과 family 차단 여부를 보고, Redis 조회 실패는 fail-closed로 처리합니다. assertGatewayHasNoServletDeps를 빌드의 check에 연결해 servlet·MVC 의존성이 들어오면 실패시키고, GatewayReactiveBootstrapTest로 리액티브 부팅을 확인했습니다.
두 검증기에 같은 입력을 넣어 결과를 비교하고, 입력과 예상 결과의 쌍을 정답 벡터(golden vector)로 고정할 계획이었습니다. 옛 검증기를 없앤 뒤에도 게이트웨이가 이 입력과 예상 판정을 계속 통과하게 하려는 방식입니다. 하지만 의존성을 검사하는 빌드 가드가 공용 모듈의 테스트 데이터 의존까지 막았습니다. 비교용 입력을 코드 의존성 없이 읽을 수 있는 파일로 다시 설계해야 했고, 이 비교는 완성하지 못했습니다.
요청 횟수 제한은 FailClosedRedisRateLimiter를 직접 만들어 대체했습니다. 고정 시간 구간마다 Redis INCR로 세고 첫 요청에서 EXPIRE를 설정합니다. Redis 오류는 예외로 전달해 503으로 응답합니다. 시간 구간의 경계에서 순간적으로 한도의 두 배까지 통과할 수 있지만, 남용 차단과 장애 시 거절을 위한 구현으로 그 오차를 받아들였습니다.
검증을 한곳에 모으면서 키를 갱신하는 방식과 필터 실행 순서도 함께 고쳤습니다.
| 문제 | 변경 |
|---|---|
| JWKS 키를 누적하면 발급 쪽에서 내린 키가 검증 쪽에 계속 남습니다. | 성공한 비어 있지 않은 응답으로 목록을 통째로 교체합니다. 실패하거나 빈 응답이면 마지막 정상 목록을 유지합니다. |
| 요청 제한이 인증보다 먼저 돌면 검증되지 않은 사용자 ID를 한도 계산에 쓸 수 있습니다. | 인증 필터 순서를 -100으로 당겨 라우트 필터보다 먼저 실행합니다. |
| 관리 엔드포인트가 외부 진입점의 8080에 함께 열릴 수 있습니다. | 관리 포트를 8081로 분리하고 Kubernetes Service에 그 포트를 선언하지 않습니다. |
공개키를 아직 받지 못했을 때는 요청을 받을 준비가 안 된 것이지, 프로세스 자체가 죽은 것은 아닙니다. 이를 전체 health의 장애로 처리하면 user-service 없이 이미지만 띄워 보는 기본 동작 검사도 503을 받게 됩니다. 그래서 프로세스 생존 여부와 요청을 받을 준비 상태인 readiness를 나눴습니다.
로그인 요청 제한은 IP 기준으로 좁혔습니다
처음에는 로그인 요청을 IP와 계정 양쪽으로 제한하려 했는데, 계정의 이메일은 요청 본문에 있었습니다. 게이트웨이에서 이를 읽고 서비스에도 다시 전달하려면 본문을 보관하는 처리가 필요했습니다. 처음 썼던 ?email 쿼리 값은 호출자가 바꿀 수 있어 계정 기준으로 삼을 수 없었습니다. 이를 제거하고 IP 단위 제한까지만 구현했습니다.
| 대상 | 한도 | 기준 |
|---|---|---|
| 로그인·가입·refresh | 10/초 | IP |
| 상품 조회 | 100/초 | IP |
| 그 외 | 40/초 | userId |
모두 1초 구간으로 셌습니다. JWKS 조회 제한 시간은 2초, 연속 갱신을 막는 대기 시간은 10초, 주기 갱신 간격은 5분으로 두었습니다. 이 수치를 고른 근거는 지금 설명하기 어려워서, 다른 환경에 적용할 기준값으로 보기는 어렵습니다.
배포 준비와 실제 전환은 다릅니다
클러스터 없이 할 수 있는 작업부터 진행했습니다. Kubernetes에 적용할 설정 파일을 생성하고, 의도하지 않은 외부 노출을 찾는 정적 검사도 만들었습니다. 이 검사가 잘못된 설정을 잡는지 확인하려고 일부러 틀린 입력도 넣었습니다.
여기까지 통과해도 실제 요청이 게이트웨이를 거친다는 뜻은 아닙니다. GKE에서 우회 경로와 위조 헤더가 차단되는지 확인한 뒤에야 기존 검증을 제거할 수 있습니다. 그래서 실 클러스터 검증을 먼저 해야 한다는 조건은 유지했습니다.
게이트웨이의 최소 Pod 수는 minReplicas: 2로 두었습니다. Pod 수를 자동으로 조절하는 HPA는 도메인 서비스 중 order-service에만 두고 있었지만, 게이트웨이에는 예외를 적용했습니다. 모든 요청이 지나는 게이트웨이 한 대가 멈췄을 때 인증 경로 전체가 함께 끊기는 상황을 피하려는 결정이었습니다.
서비스가 믿게 된 것과 남은 것
헤더 신뢰는 형식을 엄격히 봅니다
서비스는 토큰 검증 필터를 헤더 신뢰 필터로 바꾸되 CSRF, 세션 정책, 401·403 처리, MDC 순서는 유지했습니다.
| 입력 | 판정 |
|---|---|
| 사용자 정보 헤더가 모두 없음 | 익명으로 통과하고, 공개 경로 여부는 보안 설정이 판단합니다. |
양의 정수 X-User-Id와 USER 또는 ADMIN인 X-User-Role이 정확히 하나씩 있음 | 인증합니다. |
| 한쪽만 있음, 빈 값, 중복, 숫자가 아닌 ID, 알 수 없는 역할 등 | 401로 거절합니다. |
이 검사는 형식이 잘못된 헤더를 거절합니다. 올바른 형식의 헤더를 누가 넣었는지는 입구 차단이 보장해야 합니다.
테스트로 확인한 것과 아직 남은 것
| 대상 | 확인한 것 | 아직 확인하지 못한 것 |
|---|---|---|
| RS256 전환 | 서명과 검증이 맞물리는지, kid가 없거나 등록되지 않은 토큰·위조 서명·허용하지 않은 HS256과 alg=none을 거절하는지 검사했습니다. 개인키는 빌드 산출물에서 제외했습니다. | p50·p95 서명 시간 측정 테스트는 만들었지만 결과값을 남기지 못해, Cloud KMS로 옮길지 판단할 근거가 부족합니다. |
| refresh token 재사용 감지 | 단위 테스트와 Testcontainers 통합 테스트로 확인했습니다. 토큰은 원문 대신 SHA-256 해시로 저장합니다. | 테스트 밖의 실제 환경에서는 확인하지 않았습니다. |
| 게이트웨이 | 테스트와 이미지 부팅 검사를 통과했고, 입구 차단 설정과 헤더 신뢰 필터를 추가한 뒤 전체 빌드도 확인했습니다. | 실제 트래픽 전환, 두 검증기의 판정 비교를 하지 못했습니다. |
| 입구 차단과 헤더 신뢰 | 설정 파일과 외부 노출 정적 검사를 만들었습니다. | 평문 헤더를 믿는 서비스를 실제 클러스터에 배포하지 못했습니다. 검사 스크립트를 실행하지 못해 NetworkPolicy 강제와 위조 헤더 거절도 확인하지 못했습니다. |
| 롤아웃 | maxUnavailable: 0을 설정했습니다. | 무중단 전환을 입증하지 못했습니다. |
| 관찰 | — | 인증 실패를 관찰할 지표를 추가하지 못했습니다. |
이 시점에는 게이트웨이의 Authorization 전달과 옛 HS512 검증 코드도 남아 있었습니다. 코드가 준비된 것과 실제 전환을 마친 것은 구분해야 했습니다.
돌아보면 다르게 나눌 수 있었을까요?
여기부터는 구현을 마친 뒤 돌아본 생각입니다. 작업할 때 이미 검토하고 선택한 대안은 아닙니다. 글을 쓰면서 구현과 표준을 다시 대조하고, 로컬에서 확인할 수 있었던 부분도 실험해 봤습니다.
유예 시간은 탐지를 어디로 미룰까요?
RFC 9700 §4.14.2는 refresh token rotation에서 관계 정보를 보존하도록 설명합니다.
“The previous refresh token is invalidated, but information about the relationship is retained by the authorization server.”
이전 refresh token은 무효화하되, 토큰 사이의 관계 정보는 인가 서버에 남깁니다.
같은 절은 무효화된 토큰이 제시되면 침해 신호로 보고 활성 refresh token을 폐기한다고 설명합니다. PeekCart의 ROTATED, family_id, replaced_by_token_id는 그 관계를 남기는 구현입니다. family 전체 무효화에 Redis 차단 표시를 더해 access token까지 막으려 했습니다.
10초의 유예 시간은 해당 절에 없는 완화입니다. 유예 안에서 재요청을 허용하면, 먼저 발급했던 새 refresh token을 유예 없는 ROTATED로 바꿉니다. 그 토큰이 다시 제시되면 재사용 감지로 이어집니다. 따라서 이 경로에서는 탐지가 없어지기보다 해당 토큰의 다음 refresh까지 늦어지는 것으로 볼 수 있습니다. 통합 테스트는 강제 회전된 토큰의 재제시가 거부되는 것까지 확인하며, 그 테스트가 family 무효화까지 단언하지는 않습니다.
구현할 때는 먼저 발급했던 새 refresh token과 함께 나온 access token이 만료될 때까지 겹쳐 살아 있는 위험을 받아들였습니다. 이를 막으려고 토큰별 블랙리스트까지 두는 것은 과하다고 판단했습니다. 여기에 재사용을 알아채는 시점도 늦어질 수 있다는 점은, 유예 시간을 다시 보며 함께 따져야 할 대가입니다.
로컬에서 정책 강제를 확인할 수 있었습니다
Kubernetes 문서는 NetworkPolicy를 구현하는 네트워크 플러그인이 없으면 리소스를 만들어도 효과가 없다고 설명합니다.
PeekCart의 로컬 환경인 minikube는 기본 설정으로는 정책을 강제하지 않습니다. 대신 Calico를 붙여 띄울 수 있습니다(minikube 문서). 문서는 기본 CNI인 Kindnet이 NetworkPolicy를 지원하지 않는다고 설명하고 --cni calico 설정을 안내합니다.
그래서 이 글을 쓰면서 뒤늦게 실험해 봤습니다. 입구 차단을 구현할 때 수행한 검증은 아닙니다. minikube v1.38.1, Kubernetes v1.35.1, docker 드라이버에서 기본 설정과 --cni calico로 클러스터를 하나씩 띄우고, 구현해 둔 NetworkPolicy를 그대로 적용했습니다. 보호 대상은 서비스 코드 대신 nginx-unprivileged의 8080 포트를 사용했고, 요청을 보내는 Pod 네 개에는 정책이 고르는 라벨을 붙였습니다.
정책을 만들었는데, 왜 다 통과할까요?
구현해 둔 NetworkPolicy를 그대로 적용한 두 클러스터입니다. 네 Pod에서 보호 대상의 8080으로 요청을 보내 보세요.
글의 로컬 실험(minikube v1.38.1, Kubernetes v1.35.1, docker 드라이버) 결과를 옮긴 그림입니다. 보호 대상은 서비스 코드 대신 nginx-unprivileged의 8080이며, 위조 헤더가 서비스 코드까지 닿는지와 GKE Dataplane V2의 동작은 이 실험으로 확인하지 않았습니다. 000은 HTTP 응답 상태를 얻지 못한 curl 결과입니다.
| 요청을 보낸 Pod | 정책 의도 | 기본 설정 | Calico |
|---|---|---|---|
app: gateway | 허용 | 200 | 200 |
| 같은 네임스페이스의 다른 Pod | 차단 | 200 | 000 |
| monitoring의 Prometheus | 허용 | 200 | 200 |
| monitoring의 다른 Pod | 차단 | 200 | 000 |
000은 HTTP 응답 상태를 얻지 못한 curl 결과입니다. 정책 적용 전에는 양쪽 모두 네 경로가 200이었고, 적용 후 결과는 세 번 반복해 같았습니다. 기본 설정에서는 정책이 만들어져도 차단하지 않았고, Calico에서는 허용·차단 결과가 정책 의도와 맞았습니다.
기본 설정 클러스터에서는 kindnet Pod가 보이지 않았고 /etc/cni/net.d에 활성 conflist가 없었습니다. 문서의 Kindnet 기본값과 실험 환경의 상태가 같은지는 확인하지 못했습니다. Calico 클러스터에서는 10-calico.conflist가 활성 상태였습니다. 실험 후 두 클러스터를 삭제했습니다. 이때 사용한 설정과 스크립트는 작업 세션의 임시 파일에만 두었고 저장소에는 추가하지 않았습니다.
이 실험은 라벨과 포트만 재현한 최소 구성입니다. 위조 헤더가 서비스 코드까지 닿는지, 다섯 서비스 전체가 보호되는지, GKE Dataplane V2가 같은 방식으로 강제하는지는 확인하지 않았습니다. 돌아보면 로컬에서 라벨 선택과 차단 동작을 먼저 확인하고, GKE에서는 실제 환경을 검증하도록 나눌 수 있었을 것입니다. 다만 이 로컬 결과만으로 서비스가 실제 클러스터에서 보호된다고 결론낼 수는 없습니다.
두 검증기를 같은 입력으로 비교했다면
검증을 병행하도록 만들었어도, 두 구현이 같은 답을 내는지는 별도 문제였습니다. 실제 사용자 트래픽이 없었으므로 같은 토큰을 양쪽에 넣어 보는 테스트가 필요했습니다.
모듈 의존성을 연결하기 어려웠다면, 프레임워크 의존성이 없는 계약 모듈에 서명된 사용자 토큰과 예상 판정을 리소스로 고정하는 방법을 생각할 수 있습니다. 두 검증기가 각자 같은 입력을 읽게 하는 방식입니다. 실제로 구현한 방식은 아니지만, 검증을 병행하는 동안 이 비교를 넣었다면 옛 검증기를 없애기 전에 두 구현이 같은 판정을 내리는지 확인할 수 있었을 것입니다.
이 환경에서 실행할 수 있는 순서였을까요?
배포를 나누면서 Authorization을 유지한 채 우회 경로를 먼저 닫아야 한다는 순서는 분명해졌습니다. 각 상태를 별도 이미지로 만들었으므로, 새 구현에서 문제가 생겼을 때 어디로 돌아갈지도 정할 수 있었습니다.
하지만 실제 트래픽을 옮길 수 없는 환경에서 전환과 롤백 절차를 세세하게 설계했고, 헤더 신뢰 구현도 실 클러스터에 배포하지 못한 채 남았습니다. 돌아보면 “되돌릴 수 있는가”와 함께 “이 환경에서 실행할 수 있는가”도 물었어야 했습니다. 그랬다면 게이트웨이 배포 준비와 우회 경로 차단을 다르게 묶었을 수도 있습니다.
운영 중인 시스템을 가정해 순서를 설계한 경험은 남았지만, 무중단 전환에 성공했다고 말할 수는 없습니다.
처음 목표는 게이트웨이가 검증하고 서비스가 헤더를 믿게 만드는 것이었습니다. 이를 위해 키와 토큰 상태를 먼저 바꿨고, 게이트웨이 전환을 준비하면서는 기존 서비스가 읽을 정보도 남겨야 한다는 문제가 드러났습니다. 그래서 검증을 병행하고, 우회 경로를 닫고, 서비스를 바꾼 뒤에야 기존 검증을 제거하는 순서로 계획을 고쳤습니다.
아직 남은 질문은 이 순서가 실제 환경에서도 지켜지는지입니다. GKE에서 우회 경로와 위조 헤더가 차단되는지 확인할 수 있을까요? 평문 헤더의 신뢰를 NetworkPolicy 하나에 맡겨도 될까요? 네트워크 플러그인이 정책을 강제하지 않거나, 라벨이 어긋나거나, 허용된 Pod가 침해됐을 때를 생각하면 서명된 내부 토큰 같은 별도 증명이 필요한지도 더 따져봐야 합니다.