웹 요청 1,000개가 네트워크 응답을 기다리는 동안 CPU는 무엇을 실행할까요? 요청마다 스레드 하나가 붙어 있다면, 기다리는 요청의 스레드도 계속 CPU를 차지하는 걸까요? 가상 스레드를 쓰면 답이 달라질까요?
이 질문에서 출발해 프로세스, OS 스레드, Java virtual thread(VT)를 차례로 구분했습니다. 이어 컨테이너의 CPU 제한이 어디에 적용되는지 따라가다 보니 cpu.max의 시간 단위와 CPU별 slice, Linux의 실행 대기열까지 확인하게 됐습니다. 아래 요청 수는 설명을 위한 가정입니다. 실제 서버를 측정한 값은 아닙니다.
프로세스가 실행된다는 말은 무엇을 뜻할까요?
프로세스는 흔히 “메모리에 올라가 실행되는 프로그램 흐름”으로 소개됩니다. 이때는 프로그램을 실행하면서 생긴 하나의 실행 인스턴스로 생각하면 됩니다. 같은 프로그램을 여러 번 실행하면 여러 프로세스가 생길 수도 있습니다.
다만 “프로세스 = 실행 흐름 하나”라고 고정하면 뒤에서 혼란이 생깁니다. 프로세스는 실행에 필요한 메모리와 자원의 경계이고, 실제 명령을 따라 진행하는 흐름은 그 안의 스레드로 구분할 수 있습니다.
왜 프로세스를 분리할까요?
여러 프로그램이 동시에 실행될 때 서로의 메모리와 작업을 함부로 건드리지 못하게 하기 위해서입니다. 한 프로그램의 오류가 다른 프로그램의 메모리를 직접 망가뜨리지 못하도록 경계를 둡니다. 프로세스 사이의 격리는 지금도 중요합니다.
실제로 명령을 진행하는 것은 스레드입니다
1 Process = 1 Address Space + 1 Execution Flow라는 식은 프로세스 하나에 메모리 공간 하나와 실행 흐름 하나가 대응하는 단순화된 모델입니다. 이 모델에서는 “프로세스가 실행된다”라고 말해도 무엇이 CPU에서 진행되는지 비교적 분명합니다.
현대의 프로세스에는 여러 스레드가 있을 수 있습니다. 이 스레드들은 같은 프로세스의 자원을 공유하면서 각각 다른 지점의 명령을 진행합니다. 따라서 CPU가 실행할 대상을 정확히 말할 때는 프로세스 전체와 개별 OS 스레드를 구분해야 합니다.
Linux는 프로세스와 스레드를 공통적인 task 구조로 다룹니다. 같은 프로세스에 속한 스레드들은 자원을 공유할 수 있지만, 각 스레드는 별도로 실행 상태를 가집니다. 여기서 프로세스라는 개념이 없어졌다는 뜻은 아닙니다. 프로세스의 자원 경계와 스레드의 실행 흐름은 서로 다른 역할을 합니다.
참고: Linux 커널 문서 — 프로세스와 스레드의 관계, Linux clone(2) 매뉴얼 — 스레드 그룹.
용어 주의: 자료의
Kernel Thread는 문맥상 “운영체제가 스케줄링하는 OS 스레드”를 가리킵니다. Linux에서kernel thread는 커널 내부의 일을 수행하는 스레드라는 뜻으로도 쓰이므로, 이 글에서는 혼동을 피하려고 OS 스레드라고 부릅니다.
참고: Linux 커널 문서 — 실제 kernel thread 생성 API.
요청이 많아질 때 OS 스레드가 부담이 되는 이유
서버가 많은 요청을 처리한다고 해도 모든 요청이 계속 CPU로 계산하는 것은 아닙니다. 어떤 요청은 네트워크 응답이나 파일 읽기가 끝나기를 기다립니다. 작업이 많다는 것과 동시에 CPU를 쓰는 작업이 많다는 것은 다릅니다.
요청 하나마다 OS 스레드 하나를 오래 붙여 두는 방식에서는, 기다리는 요청을 위해서도 스레드를 유지해야 합니다. 스레드는 CPU를 쓰지 않는 동안에도 스택 메모리 등 관리 비용이 있습니다. 그래서 대량의 대기 작업을 처리할 때 다른 구성이 유용해집니다. 모든 멀티스레딩이 항상 부족하다는 뜻은 아닙니다.
이때 프로그램의 실행 환경이 많은 논리적 작업을 관리하고, 적은 수의 OS 스레드 위에서 실행 가능한 작업을 번갈아 진행하는 방법이 쓰입니다. virtual thread, coroutine, goroutine은 각각 방식이 다르며, async/await는 비동기 작업을 코드에 표현하는 문법입니다. 이들을 완전히 같은 종류의 스레드로 묶어서는 안 됩니다.
작업 하나와 OS 스레드 하나는 같은가요?
한 스레드가 여러 작업을 맡는 방식은 새로 생긴 걸까요?
핵심 방향은 맞지만 시대를 그렇게 둘로 나누면 부정확합니다. 과거에도 스레드 풀처럼 한 스레드가 여러 작업을 차례로 처리하는 방식은 있었습니다. 여기서 중요한 변화는 아직 끝나지 않은 많은 작업을 각각 OS 스레드 하나에 계속 묶어 두지 않을 수 있다는 점입니다. 대기 중인 작업을 잠시 멈춰 두고, 그 OS 스레드에서 다른 작업을 진행합니다.
여기서 말하는 “작업”은 job일까요?
넓은 뜻에서는 그렇습니다. 웹 서버라면 “요청 하나를 처리하는 일”이 예가 됩니다. 다만 작업마다 항상 하나의 OS 스레드가 전담하는 것은 아닙니다. 작업은 CPU 계산을 할 수도 있고, 외부 응답을 기다릴 수도 있습니다. 기다리는 작업은 그 순간 CPU를 점유하지 않습니다.
작업을 바꾸는 것과 OS의 시분할은 같을까요?
둘 다 번갈아 실행하는데, 무엇이 움직일까요?
CPU0 하나를 OS 스레드 T1·T2가 나눠 쓰고, T1 위에는 VT A·B가 번갈아 올라갑니다. 두 전환을 눌러 보고 무엇이 움직이는지 비교해 보세요.
지원되는 I/O 대기에서 VT가 carrier에서 내려오는 경우를 그린 모형입니다. 번갈아 보여주려고, 대기 중인 VT의 I/O는 그사이 끝났다고 가정했습니다. I/O 요청에 쓰이는 syscall과 carrier가 고정되는 경로는 생략했습니다.
둘 다 시간상 번갈아 실행하지만 전환 대상과 결정 주체가 다릅니다.
| 구분 | 번갈아 실행되는 대상 | 결정 주체 |
|---|---|---|
| OS의 시분할 | CPU 위의 OS 스레드들 | 커널의 스케줄러 |
| 논리적 작업 전환 | OS 스레드 위의 작업들 | 프로그램의 실행 환경 또는 라이브러리 |
OS 스레드 전환:  스레드 1(작업 A) → 스레드 2(작업 C) → 스레드 1(작업 A)
작업 전환:      스레드 1(작업 A) → 스레드 1(작업 B) → 스레드 1(작업 A)
OS가 스레드 1을 잠시 멈췄다가 다시 실행한다고 해서 자동으로 작업 B가 시작되는 것은 아닙니다. 같은 스레드에서 A를 멈추고 B를 선택하는 일은 그 작업을 관리하는 실행 환경이 맡습니다. 두 종류의 전환은 실제 시스템에서 함께 일어납니다.
“커널이 모르는 실행 흐름”은 무슨 뜻일까요?
커널이 그 흐름을 별도의 OS 스레드로 등록해 직접 스케줄링하지 않는다는 뜻입니다. 예를 들어 OS 스레드 4개 위에 virtual thread 1,000개가 있어도, 커널은 그 virtual thread 1,000개 각각을 OS 스레드로 다루지 않습니다. 어떤 virtual thread를 어느 OS 스레드에서 진행할지는 실행 환경이 관리합니다.
커널과 완전히 무관하거나 보이지 않는다는 뜻은 아닙니다. 커널은 여전히 OS 스레드의 실행 순서를 정하고, 프로그램이 요청한 파일·네트워크 작업도 처리합니다. 커널은 개별 논리적 작업을 직접 스케줄링 대상으로 삼지 않는다는 뜻입니다.
“커널이 아는 실행 흐름”은 무엇일까요?
여기서 “커널이 아는 실행 흐름”은 커널이 CPU 실행 대상으로 관리하는 OS 스레드를 뜻합니다. 프로세스에는 메모리와 자원이 있고, OS 스레드는 그 프로세스에 속해 명령을 실행합니다. 커널은 이 둘을 관리합니다.
커널: 프로세스와 OS 스레드를 관리하고, OS 스레드의 실행 순서를 정함
프로세스: 실행에 필요한 메모리·자원의 경계
  ├─ OS 스레드 1: 실행 흐름
  └─ OS 스레드 2: 실행 흐름
따라서 커널 → 프로세스 → 스레드는 관계를 떠올리는 데 도움이 되지만, 커널이 프로세스를 담는 상자이고 프로세스가 스레드의 관리자라는 뜻은 아닙니다.
프로세스가 아닌 커널이 OS 스레드를 관리하는 이유
프로세스는 관리자가 아니라 자원의 경계입니다. CPU는 서로 다른 프로세스에 속한 스레드들이 함께 사용합니다. 누가 다음에 CPU를 쓸지 결정하려면 모든 프로세스의 실행 가능한 스레드를 볼 수 있는 커널이 필요합니다. 커널은 스레드를 멈추고 다른 스레드로 바꾸는 일도 맡습니다.
프로세스 안의 실행 환경은 자기 OS 스레드 위에서 어떤 논리적 작업을 할지 정할 수 있습니다. 하지만 자기 OS 스레드가 CPU를 언제 받을지까지 독자적으로 정할 수는 없습니다.
Java VT는 어느 스레드에서 실행될까요?
두 단계의 배치를 함께 놓으면 구조가 드러납니다. Java 실행 환경이 여러 virtual thread를 carrier OS 스레드에 배치하고, 커널이 그 OS 스레드를 CPU에 배치합니다. N과 M은 각각의 개수이며 고정된 비율을 뜻하지 않습니다.
프로세스 안의 Java 실행 환경
  virtual thread N개 → carrier OS 스레드 M개 → CPU
       Java 런타임이 선택             Linux 커널이 선택
참고: Oracle 문서 — virtual thread와 OS 스레드의 관계.
여러 VT를 carrier에 싣는 multiplexing은 무엇일까요?
여러 논리적 실행 흐름이 더 적은 수의 OS 스레드를 시간에 따라 함께 쓰도록 하는 것입니다. OS 스레드 하나가 같은 순간에 두 virtual thread를 실행한다는 뜻은 아닙니다. 한 virtual thread가 기다리는 동안 다른 virtual thread를 그 OS 스레드에 배치할 수 있습니다.
virtual thread가 늘어나도 carrier는 왜 덜 필요할까요?
요청마다 스레드 하나를 붙이는 익숙한 코드 형태를 유지하면서도, 많은 대기 요청을 적은 수의 OS 스레드로 처리할 수 있다는 뜻입니다. Java에서는 virtual thread를 실제로 실행할 때 사용하는 OS 스레드를 carrier thread라고 부릅니다. virtual thread의 실행 순서는 Java 실행 환경이 정하지만, carrier thread의 CPU 사용 순서는 여전히 커널이 정합니다. 참고: Oracle 문서 — virtual thread의 스케줄링.
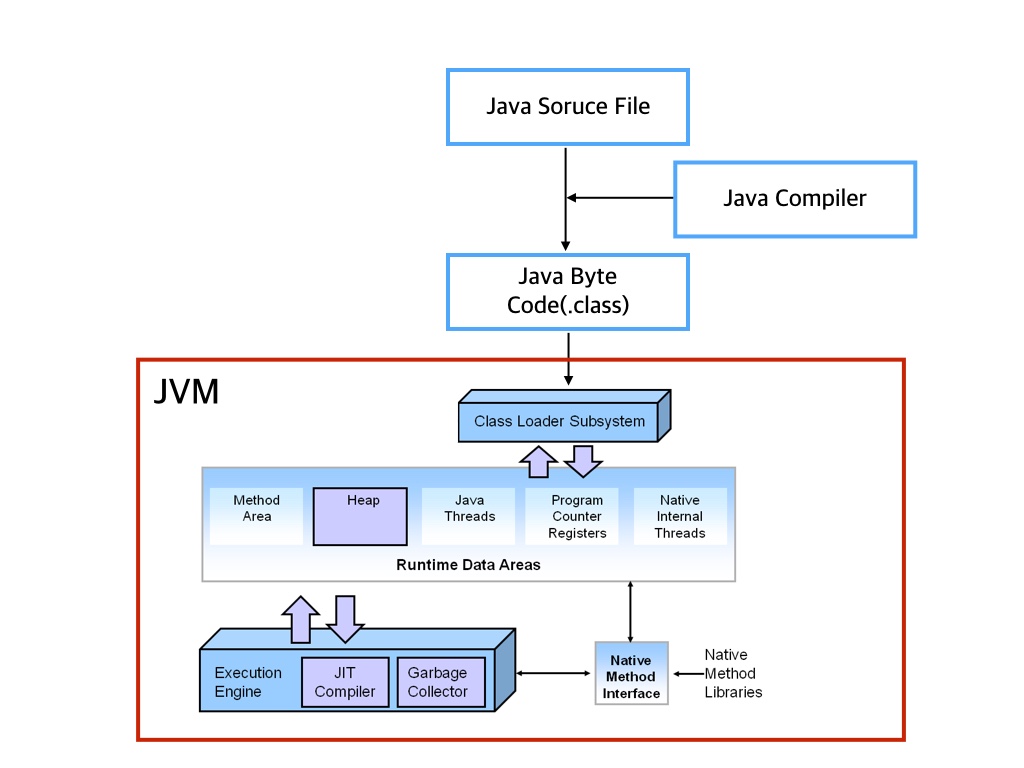
처음 이해를 바로잡으면: virtual thread가 syscall 자체를 우회한다고 설명하면 부정확합니다. 파일이나 네트워크 작업에는 여전히 운영체제가 관여합니다. 주요 이점은 virtual thread가 I/O를 기다리는 동안 OS 스레드를 다른 작업에 쓸 수 있다는 점입니다. virtual thread가 CPU 계산 자체를 빠르게 하지는 않습니다. 참고: Oracle 문서 — virtual thread의 쓰임과 한계, Linux 매뉴얼 — syscall 인터페이스.
syscall은 스레드 전환과 어떻게 다를까요?
커널 모드
CPU가 운영체제 커널의 코드를 실행하는 상태입니다. 일반 프로그램의 코드가 실행되는 사용자 모드와 대비됩니다. 사용자 프로그램은 파일이나 장치 등 보호된 자원을 마음대로 조작하지 못하므로, 필요한 작업을 커널에 요청합니다. 같은 OS 스레드가 사용자 모드에서 실행되다가 요청을 처리하는 동안 커널 모드로 들어갈 수 있습니다. 참고: Linux syscall(2) 매뉴얼 — 커널 모드 진입.
syscall(시스템 호출)
프로그램이 커널의 서비스를 요청하는 정해진 통로입니다. 예를 들어 파일을 읽어 달라는 요청이 있습니다. 시스템 호출을 하면 커널이 필요한 작업을 수행하고 결과를 돌려줍니다. syscall을 한다는 것과 다른 OS 스레드로 바뀐다는 것은 별개의 일입니다. 참고: Linux syscalls(2) 매뉴얼 — 프로그램과 커널의 인터페이스, Linux 커널 문서 — 시스템 호출 이후 원래 코드로 복귀.
carrier thread
Java virtual thread를 실제로 실행할 때 그 아래에서 CPU 명령을 수행하는 OS 스레드입니다. virtual thread A가 지원되는 I/O 작업을 기다리며 멈추면 Java 실행 환경이 A를 carrier에서 내려놓고, 그 carrier에 다른 virtual thread B를 배치할 수 있습니다. 커널은 그 carrier thread를 OS 스레드로 스케줄링합니다. 참고: Oracle 문서 — virtual thread와 carrier thread.
커널 코드의 실제 예시는 무엇일까요?
파일을 읽는 read() 요청을 생각할 수 있습니다. 프로그램이 “이 파일에서 데이터를 읽어 달라”고 요청하면, 커널의 파일 시스템 관련 코드는 전달받은 파일 번호에 대응하는 파일을 찾고, 읽기 작업을 수행해 결과를 프로그램에 돌려줍니다. 이미 메모리에 있는 데이터로 처리될 수도 있으므로, read()를 호출할 때마다 디스크를 직접 읽는 것은 아닙니다. 이런 파일 시스템 처리는 프로그램의 read() 호출 자체가 아니라, 요청을 받은 뒤 실행되는 커널 내부 코드의 예입니다. 참고: Linux read(2) 매뉴얼, Linux 커널 문서 — VFS와 파일 읽기.
커널 코드를 실행하게 하는 명령어나 API는 무엇일까요?
터미널에서 cat file.txt를 실행하면 cat이라는 일반 프로그램이 파일을 열고 내용을 읽어 출력합니다. 그 과정에서 프로그램은 파일 읽기 등의 시스템 호출을 사용하고, 요청을 처리하는 커널 내부 코드가 실행됩니다. cat 명령 자체가 커널 코드인 것은 아닙니다.
C 코드의 read(fd, buffer, count)도 예입니다. 프로그램이 호출하는 read()는 사용자 공간에 제공되는 함수/API이고, 이 함수가 Linux의 read 시스템 호출을 통해 커널에 작업을 요청합니다. 즉 명령어·라이브러리 API → 시스템 호출 → 커널 코드라는 관계입니다. 상위 언어의 파일 읽기 API도 보통 이러한 운영체제 인터페이스를 거칩니다. 실제로 어떤 시스템 호출을 몇 번 사용하는지는 언어, 라이브러리, 구현에 따라 달라질 수 있습니다. 참고: Linux syscalls(2) 매뉴얼 — 라이브러리 함수와 시스템 호출의 관계, Linux read(2) 매뉴얼.
fork, wait, exec도 커널 코드일까요?
프로그램에서 부르는 이 이름들은 우선 API 이름입니다. 이 호출들이 시스템 호출을 거쳐 커널 코드를 실행시킵니다. fork()는 자식 프로세스를 만들고, wait()는 자식의 상태 변화를 기다리며, exec 계열은 현재 프로세스가 실행하는 프로그램을 다른 프로그램으로 바꿉니다. 성공한 execve()는 새 프로세스를 만드는 것이 아니라 기존 프로세스의 프로그램을 교체합니다.
이름이 같은 API와 시스템 호출이 항상 1:1로 대응하는 것은 아닙니다. Linux의 glibc 구현에서 fork() 함수는 clone 시스템 호출을 이용하고, wait() 함수는 wait4 시스템 호출을 이용합니다. exec은 함수 하나의 이름이라기보다 execl, execvp 등의 함수 묶음을 가리키며, 이들은 execve 시스템 호출에 기반합니다. 참고: Linux fork(2) 매뉴얼, Linux wait(2) 매뉴얼, Linux exec(3) 매뉴얼, Linux execve(2) 매뉴얼.
VT에서는 커널 모드 진입이 정말 줄어들까요?
항상 적어지는 것은 아닙니다. 이 질문은 “syscall 오버헤드를 우회한다”는 설명에서 나온 오해입니다. virtual thread도 파일·네트워크 I/O를 요청할 때 운영체제의 인터페이스를 이용합니다. 따라서 같은 I/O 작업을 한다면 syscall과 커널 모드 진입이 저절로 사라지지 않습니다. 구현에 따라 I/O를 감시하는 추가 시스템 호출이 생길 수도 있으므로, 횟수가 반드시 줄어든다고 말할 수 없습니다.
줄일 수 있는 것은 논리적 작업 A와 B를 번갈아 실행하기 위해 매번 OS 스레드 자체를 바꿔야 하는 필요입니다. 실행 환경이 A를 멈추고 B를 같은 carrier thread에서 실행시키는 전환은, 경우에 따라 커널이 다른 OS 스레드를 선택하는 절차 없이 이루어집니다. 하지만 carrier thread 자체의 CPU 스케줄링과 I/O 요청에는 여전히 커널이 관여합니다. virtual thread의 주된 이점은 대기 중인 작업마다 OS 스레드를 붙잡아 두지 않아도 된다는 점입니다. 참고: OpenJDK JEP 444 — virtual thread의 mount/unmount, Oracle 문서 — blocking I/O와 carrier 재사용, Linux syscalls(2) 매뉴얼.
carrier를 재사용하면 무엇이 줄어들까요?
OS 스레드를 작업마다 새로 만들거나 대기 중인 작업에 계속 붙잡아 둘 필요가 줄어드는 이유로는 맞습니다. virtual thread A가 지원되는 대기 작업에서 멈추면, Java 실행 환경이 A를 carrier thread에서 내려놓고 같은 carrier thread에 B를 배치할 수 있습니다. 이 전환을 위해 반드시 다른 OS 스레드로 바꿀 필요는 없습니다. 하지만 carrier 재사용이 syscall 횟수나 커널 모드 진입 횟수를 반드시 줄이는 것은 아닙니다. I/O 요청은 여전히 커널을 이용합니다. 일반적인 스레드 풀도 OS 스레드를 재사용하지만, virtual thread의 특징은 아직 끝나지 않은 A가 기다리는 동안 carrier를 B에 쓸 수 있다는 점입니다. 참고: OpenJDK JEP 444, Oracle 문서 — carrier 재사용.
그러면 작업의 대기 시간도 짧아질까요?
작업 A가 기다리는 시간 자체가 짧아진다는 뜻은 아닙니다. A는 네트워크나 파일 작업이 끝날 때까지 여전히 기다립니다. 달라지는 것은 그동안 carrier thread가 A와 함께 묶여서 기다릴 필요가 줄어든다는 점입니다. 실행 가능한 작업 B가 있다면 carrier thread는 B를 수행할 수 있습니다. 따라서 많은 작업이 I/O를 기다리는 서버에서는 같은 수의 OS 스레드로 더 많은 요청을 진행해 처리량을 높일 수 있습니다. 개별 요청이 반드시 더 빨리 끝나는 것은 아닙니다. 참고: Oracle 문서 — virtual thread는 처리량 확장을 위한 것.
여기까지의 실행 단위를 연결해 보면
프로세스: 메모리와 자원을 가진 실행 인스턴스
  └─ OS 스레드: 커널이 CPU 실행 대상으로 관리
       └─ 논리적 작업: 실행 환경이 OS 스레드에 배치하고 전환

커널의 결정: 어느 OS 스레드가 CPU를 쓸까?
실행 환경의 결정: 그 OS 스레드에서 어느 논리적 작업을 진행할까?
이 그림은 개념을 단순화한 것입니다. 여러 OS 스레드와 여러 논리적 작업의 관계가 항상 고정된 1:1 대응은 아닙니다.
컨테이너의 CPU 제한은 어디에 걸릴까요?
여기까지는 CPU를 누가 실행하는가를 살폈습니다. 이제 여러 스레드가 CPU를 함께 쓸 때 얼마나 실행할 수 있는가로 질문을 옮겨 보겠습니다. 코어가 여러 개면 일부 스레드는 실제로 동시에 실행될 수 있으므로 “모두 동시에 보이기만 한다”는 뜻은 아닙니다.
Docker에서 컨테이너의 CPU·메모리 사용 한도를 설정하면, Linux에서는 cgroup 기능을 통해 해당 컨테이너에 속한 작업들의 자원 사용을 추적하고 제어합니다. Docker의 설정은 사용자에게 보이는 인터페이스이고, 실제 제한은 커널의 자원 제어 기능이 적용합니다. CPU 제한은 물리적인 코어 하나를 컨테이너에 떼어 준다는 뜻이 아니며, 구체적인 의미는 뒤의 cpu.max 문단에서 다시 학습합니다. 참고: Docker 문서 — 컨테이너 자원 제한, Linux 커널 문서 — cgroup v2.
Container Runtime, Resource Limit, mem, cgroup은 무엇일까요?
| 표현 | 여기서의 뜻 |
|---|---|
| Container Runtime | 컨테이너를 만들고 시작·중지하며 실행에 필요한 설정을 적용하는 소프트웨어. Docker는 사용자가 이를 다루는 대표적인 도구입니다. |
| Resource Limit | 컨테이너가 사용할 수 있는 CPU 시간이나 메모리 양 등에 설정한 사용 한도. |
| mem | memory의 줄임말로, 여기서는 컨테이너가 쓰는 메모리를 뜻합니다. |
| cgroup | Linux 커널의 control group 기능. 관련 작업들을 그룹으로 묶고 CPU·메모리 등의 사용량을 추적하고 제어합니다. |
흐름은 사용자가 Docker에서 제한을 지정 → 실행 도구가 해당 작업을 cgroup에 넣고 제한값을 설정 → Linux 커널이 사용량을 제어하는 식입니다. cgroup 자체가 CPU 코어나 메모리 칩을 별도로 만들어 주는 것은 아닙니다. 참고: Docker 문서 — Resource constraints, Docker 문서 — cgroup을 통한 사용량 측정, Linux 커널 문서 — cgroup v2.
cgroup은 스레드도 묶을 수 있을까요?
그렇지만 기본 방식과 특수한 스레드 모드를 구분해야 합니다. Linux에서는 각각의 OS 스레드가 커널이 관리하는 실행 단위인 task로 표현됩니다. 일반적인 cgroup v2에서는 프로세스를 그룹에 넣고, 그 프로세스의 모든 스레드가 기본적으로 같은 cgroup에 속합니다. 그러므로 프로세스를 묶으면 그 안의 스레드들의 자원 사용도 함께 영향을 받습니다.
cgroup v2의 threaded mode에서는 지원되는 일부 자원 제어 기능에 한해 스레드별로 cgroup 트리의 다른 위치에 놓을 수 있습니다. 따라서 “cgroup은 오직 프로세스만 다룬다”는 말은 부정확하지만, “프로세스와 스레드를 아무 제약 없이 자유롭게 섞어 묶는다”는 이해도 부정확합니다. 프로세스는 스레드와 나란히 존재하는 별개의 CPU 실행 단위라기보다, 여러 스레드가 공유하는 자원과 스레드 그룹의 관점입니다. 참고: Linux 커널 문서 — cgroup v2의 process와 thread 구성.
스레드 하나를 옮기면 프로세스 전체도 따라갈까요?
일반적인 cgroup v2 모드에서는 그렇습니다. 프로세스 단위로 소속을 정하므로, 같은 프로세스의 모든 스레드가 같은 cgroup에 들어갑니다. 스레드 하나의 ID를 사용해 프로세스를 이동시키더라도 모든 스레드가 함께 이동합니다.
threaded mode는 예외입니다. 같은 프로세스의 스레드들을 하나의 threaded subtree 안에서 서로 다른 하위 cgroup에 둘 수 있습니다. 그 프로세스는 공통 자원 영역인 threaded domain에 속한 것으로 취급됩니다. 따라서 특정 하위 cgroup에 스레드 하나를 배치했다고 해서 프로세스의 모든 스레드가 그 하위 cgroup으로 옮겨지는 것은 아닙니다. 참고: Linux 커널 문서 — cgroup v2에서 프로세스와 스레드 이동.
스레드들이 흩어지면 프로세스도 여러 cgroup에 속할까요?
아닙니다. 프로세스는 여러 cgroup에 동시에 속하지 않습니다. 일반 모드에서는 프로세스와 모든 스레드가 같은 cgroup에 속합니다. threaded mode에서는 그 프로세스가 하나의 threaded domain에 속한 것으로 취급되고, 개별 스레드는 그 아래의 서로 다른 threaded cgroup에 있을 수 있습니다.
D: threaded domain — P를 포함해 여러 프로세스를 담을 수 있는 공통 자원 영역
├─ A: threaded cgroup — P의 스레드 T1
└─ B: threaded cgroup — P의 스레드 T2
여기서 P가 A와 B 두 곳에 동시에 속하는 것은 아닙니다. 또한 “부모 프로세스”보다는 “스레드가 속한 프로세스”라는 표현이 정확합니다. 같은 프로세스의 스레드들은 부모·자식 프로세스 관계가 아닙니다. 참고: Linux 커널 문서 — threaded subtree와 threaded domain.
thread group과 threaded cgroup은 같은 뜻일까요?
cgroup의 대상 범위를 프로세스 단위 또는 스레드 단위로 다룰 수 있다는 이해가 맞습니다. 그러나 threaded cgroup은 “한 프로세스 안의 스레드 그룹”과 같은 뜻이 아닙니다. 한 프로세스의 스레드들을 가리키는 thread group은 프로세스 구조에 관한 개념이고, cgroup은 여러 프로세스 또는 스레드의 자원 사용을 묶어 제어하는 개념입니다. threaded subtree에는 여러 프로세스의 스레드가 들어갈 수 있습니다.
예를 들어 프로세스 P의 스레드 T1과 프로세스 Q의 스레드 T3이 같은 threaded cgroup A에 들어갈 수 있습니다. 이는 P와 Q가 같은 프로세스라는 뜻이 아니라, 해당 자원 제어를 위해 두 스레드를 같은 cgroup에 두었다는 뜻입니다. 참고: Linux 커널 문서 — cgroup v2의 threaded mode, Linux clone(2) 매뉴얼 — 프로세스의 thread group.
cgroup은 CPU 시간을 어떻게 제한할까요?
cgroup은 CPU를 물리적으로 떼어 줄까요?
처음에는 cgroup을 막연한 CPU 배분 알고리즘으로 생각했습니다. 그러면서도 CPU 자원을 물리적으로 떼어 주는 것은 아닐 것이라고 짐작했습니다. cgroup은 커널이 작업들을 계층적으로 조직하고 CPU·메모리 등 자원 사용을 제어하는 기능입니다. 컨테이너마다 물리 CPU 코어를 새로 만들거나 자동으로 독점 배정하는 장치는 아닙니다. CPU를 특정 코어들로 제한하는 cpuset 설정은 별도로 구별해야 합니다. 참고: Linux 커널 문서 — cgroup v2의 기본 개념.
cgroup의 CPU 제어: weight, quota, throttle
cgroup은 작업들을 부모·자식 관계의 그룹으로 조직하고 자원 사용을 제어합니다. CPU를 제어하는 기능에는 두 방식이 있습니다.
| 방식 | 뜻 |
|---|---|
weight | 여러 그룹이 CPU를 놓고 경쟁할 때 상대적으로 어느 쪽에 더 많이 배분할지 정합니다. 다른 그룹이 CPU를 쓰지 않는다면 고정된 사용량 한도가 되는 것은 아닙니다. |
quota | 정해진 기간 동안 그룹이 사용할 수 있는 CPU 실행 시간의 최대치를 정합니다. |
여기서 다루는 cgroup v2의 cpu.weight와 cpu.max는 일반적인 Linux FAIR 클래스 작업에 적용됩니다. 현재 커널 문서는 해당 콜백을 구현한 BPF 스케줄러도 적용 대상에 포함합니다. RT·DL 정책까지 같은 방식으로 제한된다고 일반화해서는 안 됩니다. 참고: Linux 커널 문서 — CPU 인터페이스별 적용 범위.
그룹이 해당 기간의 quota를 다 썼는데도 실행할 작업이 있으면, 다음에 사용 가능해질 때까지 CPU 실행이 제한됩니다. 이것이 CPU throttling입니다. 이제 숫자 계산과 여러 CPU 코어가 동시에 quota를 쓰는 문제를 살펴보겠습니다. 참고: Linux 커널 문서 — 가중치에 따른 배분, Linux 커널 문서 — cpu.weight, cpu.max, cpu.stat.
quota와 throttle은 무엇일까요?
quota는 일정 기간마다 cgroup에 주어지는 CPU 실행 시간 예산입니다. 예를 들어 100ms의 기간마다 50ms의 CPU 실행 시간을 허용하면, 그룹에 속한 스레드들이 그 기간에 합쳐서 50ms의 CPU 시간을 쓸 수 있습니다. 기간이 바뀌면 예산이 다시 주어집니다. 실제 설정은 cgroup v2의 cpu.max에 MAX PERIOD 형식으로 들어갑니다.
throttle은 실행할 작업이 남아 있는데도 quota를 다 써서 CPU 실행이 잠시 막힌 상태를 뜻합니다. CPU를 당장 못 쓰는 모든 상황이 throttle은 아닙니다. 예를 들어 단순히 다른 작업이 CPU를 먼저 쓰고 있어 기다리는 상황이나 I/O를 기다리는 상황은 여기서 말하는 quota throttling과 구별해야 합니다. 참고: Linux 커널 문서 — cpu.max와 cpu.stat.
quota를 “예산의 70%”처럼 선언할까요?
사용자에게 보이는 설정에서는 0.7 CPU처럼 비율에 가까운 형태를 쓸 수 있습니다. 하지만 Linux cgroup v2의 cpu.max는 허용 CPU 시간(MAX)과 기간(PERIOD) 두 값을 마이크로초로 설정합니다. 예를 들어 70000 100000은 100ms의 실제 시간 동안 그룹 전체가 합산 CPU 실행 시간 70ms까지 사용할 수 있다는 뜻이고, 평균적으로 CPU 코어 하나의 70% 분량에 해당합니다. 서버 전체가 8코어라면 그 전체 처리 능력의 70%를 뜻하는 것은 아닙니다. CPU 코어를 물리적으로 70%만 배정한다는 뜻도 아닙니다. Docker에서는 비슷한 한도를 --cpus=0.7처럼 지정할 수 있습니다. 참고: Linux 커널 문서 — cpu.max, Docker 문서 — --cpus와 quota/period.
컨테이너의 작업이 cgroup에 들어가는 과정
컨테이너 안에서 프로그램이 실행되면 하나 이상의 프로세스가 생기고, 그 프로세스에는 OS 스레드들이 있을 수 있습니다. 실행 도구는 해당 컨테이너의 작업들이 속할 cgroup과 자원 제한을 설정합니다. 일반적인 cgroup v2 모드에서 프로세스의 스레드들은 같은 cgroup에 속하고, 새 자식 프로세스는 부모가 속한 cgroup을 물려받습니다. 따라서 Docker가 생성되는 스레드 하나하나를 매번 직접 옮긴다고 이해할 필요는 없습니다.
그래서 컨테이너의 CPU·메모리 제한이 그 안에서 실행되는 작업들에 함께 적용됩니다. 컨테이너 자체를 “스레드들의 모음”으로만 정의하면 부정확합니다. 컨테이너에는 실행 작업을 격리하는 다른 구성도 있습니다. 참고: Linux 커널 문서 — cgroup의 프로세스와 스레드 소속, Docker 문서 — 컨테이너의 cgroup.
cgroup hierarchy는 cgroup 하나와 같을까요?
컨테이너 설명에서 “컨테이너에 설정된 cgroup”과 “cgroup hierarchy”를 비슷하게 읽기 쉽지만, 엄밀히 같은 말은 아닙니다. cgroup은 그룹 하나 또는 그룹을 다루는 Linux 기능을 가리킬 수 있고, hierarchy는 부모·자식 관계로 연결된 cgroup들의 전체 트리 구조를 뜻합니다. 따라서 한 cgroup은 트리의 한 위치이고, hierarchy는 그 위치들을 연결한 구조입니다.
“같은 cgroup hierarchy로 묶는다”는 표현은 범위가 넓습니다. cgroup v2에는 기본적으로 하나의 통합 hierarchy가 있으므로, 컨테이너 자원 제한 맥락에서는 “해당 컨테이너의 cgroup 또는 그 하위 트리에 속하게 한다”고 읽는 편이 분명합니다. 참고: Linux 커널 문서 — cgroup v2의 단일 hierarchy와 계층 구조.
cpu.max의 MAX PERIOD는 무엇을 뜻할까요?
cgroup v2의 cpu.max는 CPU 사용 한도를 MAX PERIOD 두 값으로 표현합니다. 단위는 마이크로초입니다. PERIOD는 예산을 계산하는 실제 시간의 길이, MAX는 그 기간 동안 cgroup에 속한 작업들이 합쳐서 사용할 수 있는 CPU 실행 시간의 최대치입니다. 예를 들어 50000 100000이면 100ms 기간마다 총 CPU 실행 시간 50ms가 허용됩니다. 실행 가능한 작업이 없다면 50ms를 반드시 써야 하는 것은 아닙니다. 여러 코어에서 동시에 실행되면 각 코어의 실행 시간이 합산되어 예산이 소모됩니다. 참고: Linux 커널 문서 — cpu.max 형식과 단위.
PERIOD가 1000ms라면 50000은 몇 ms일까요?
단위가 다릅니다. cpu.max의 두 숫자는 모두 마이크로초(µs)입니다. 1000ms = 1,000,000µs, 50,000µs = 50ms이므로 cpu.max = 50000 1000000은 실제 시간 1000ms마다 그룹 전체의 합산 CPU 실행 시간 최대 50ms라는 뜻입니다. 이는 평균적으로 CPU 하나의 5% 분량에 해당합니다. 50,000ns는 50µs이므로 50000과 혼동하면 안 됩니다. 참고: Linux 커널 문서 — CPU 설정 시간 단위와 cpu.max.
“1 CPU 분량”의 정확한 의미
Docker 같은 컨테이너의 CPU 사용 한도를 1 CPU 분량으로 설정하고 기간이 100ms라면 cpu.max = 100000 100000으로 표현할 수 있습니다. cgroup 전체가 실제 시간 100ms마다 합산 CPU 실행 시간 최대 100ms를 쓸 수 있다는 뜻입니다. 이것은 특정 물리 CPU 코어 하나를 독점하거나, 매 100ms 구간마다 반드시 100ms를 사용한다는 뜻이 아닙니다. 여러 코어에서 동시에 실행되면 합산 CPU 시간이 더 빨리 소모될 수 있습니다. vCPU라는 말은 VM의 가상 CPU 등 다른 맥락에서도 쓰이므로, 여기서는 컨테이너 CPU quota를 1 CPU 분량으로 설정한 경우를 가리킵니다. 참고: Docker 문서 — --cpus와 quota/period, Linux 커널 문서 — cpu.max.
period 중간에 throttle이 생기는 경우
CPU가 늘면 100ms quota는 언제 바닥날까요?
cpu.max = 100000 100000인 cgroup의 스레드가 CPU 여러 개에서 동시에 실행된다고 가정합니다. CPU 수를 고르고, 바닥나는 시점을 예상한 뒤 재생해 보세요.
그룹의 FAIR 스레드가 고른 CPU마다 하나씩 쉬지 않고 실행되는 교육용 계산입니다. 다른 작업과의 경쟁, CPU별 slice와 잔여 slice, 실제 커널의 정산 경계는 생략했습니다. 실제 측정값이 아닙니다.
두 코어에서 그룹의 스레드가 동시에 실행되는 다음 예를 보면 period 중간의 throttle을 이해하기 쉽습니다.
실제 시간       0ms                 50ms                100ms
CPU0의 실행     T1 실행 50ms         throttle             다음 period
CPU1의 실행     T2 실행 50ms         throttle             다음 period
그룹 CPU 예산   합계 100ms 소모      잔액 0ms             갱신
1 CPU = 100ms quota / 100ms period 예시를 볼 때는 실행하는 CPU 수를 함께 봐야 합니다. 한 코어에서 한 스레드만 계속 실행한다면 100ms quota는 100ms period가 끝날 때쯤 소진되므로 중간에 긴 throttle 구간이 생기지 않습니다. 그러나 두 스레드가 두 코어에서 동시에 각각 50ms의 실제 시간 동안 실행되면 합산 CPU 실행 시간이 100ms가 되어, period 중간에 quota가 소진될 수 있습니다. 이후 남은 실제 시간에는 throttle이 생길 수 있습니다. 이는 개념 예시이며 실제 경계는 커널의 실행 시간 계산에 따라 달라질 수 있습니다. 참고: Linux 커널 문서 — CFS bandwidth control의 quota 갱신과 throttling, Linux 커널 문서 — cgroup v2 cpu.max.
여러 CPU가 하나의 quota를 나눠 쓸 때
여러 스레드의 사용량은 어떻게 합산할까요?
한 cgroup에 스레드가 많고 여러 CPU에서 동시에 실행될 때는 같은 quota를 어떻게 합산·관리할까? 스레드마다 별도 quota를 주는 것이 아니라 cgroup 전체가 CPU 시간 예산을 공유합니다. 모든 코어가 하나의 숫자를 계속 갱신하면 생길 수 있는 문제를 살펴보겠습니다. 참고: Linux 커널 문서 — cgroup quota와 CPU별 실행 큐.
공유 quota를 모든 CPU가 직접 갱신하면 생기는 문제
여러 CPU 코어에서 같은 cgroup의 스레드가 동시에 실행되면 하나의 전역 quota를 함께 소비합니다. 만약 각 코어가 아주 자주 하나의 전역 잔액을 직접 읽고 바꾼다면, 같은 데이터를 수정하려는 코어들이 서로 기다려야 합니다. 또한 그 데이터가 있는 캐시 라인을 코어들 사이에서 계속 넘겨야 하므로 비용이 커집니다. 이것이 lock contention과 cache line bouncing의 부담입니다. 여기서 왜 quota를 CPU별 작은 몫으로 나눠서 쓰는가라는 질문이 나옵니다. 참고: Linux 커널 문서 — 전역 예산을 CPU별 slice로 전달하는 이유.
Kubernetes의 CPU limit에서 CPU별 slice까지
Kubernetes CPU limit → cgroup cpu.max = 100000 100000
                            ↓
                   전역 quota: 100ms / 100ms
                   cfs_bandwidth runtime = 100ms
                            ↓ 필요할 때 분배
          CPU0 cfs_rq: 5ms   CPU1 cfs_rq: 5ms   CPU2 cfs_rq: 5ms
          T1 실행           T2 실행           T3 실행
도식의 cpu.max = 100000 100000은 100ms 기간마다 cgroup 전체가 CPU 시간 100ms까지 사용하도록 설정한 예입니다. Kubernetes에서 이와 연결되는 것은 CPU limit이며, CPU request는 보통 상대적 가중치에 연결됩니다. 실제 설정은 노드의 kubelet과 컨테이너 실행 도구를 통해 Linux cgroup에 반영됩니다. 참고: Kubernetes 문서 — CPU request와 limit의 적용.
cfs_bandwidth의 runtime = 100ms는 기간이 시작될 때의 전역 잔여 예산입니다. CPU0, CPU1, CPU2가 각각 5ms를 받는다면, 이는 100ms와 별도로 새로 생긴 예산이 아니라 전역 예산에서 각 CPU 쪽으로 옮겨 둔 몫입니다. 셋에 5ms씩 할당했다면 단순 계산상 전역 미할당분은 85ms입니다. 실제로는 필요한 CPU가 작은 몫을 받아서 쓰고, 다 쓰면 다시 요청하는 방식입니다. 이런 분배는 모든 CPU가 전역 잔액을 매 순간 수정하는 비용을 줄입니다. 도식의 cfs_rq는 각 CPU에서 해당 cgroup의 실행 대상을 관리하는 큐입니다. 참고: Linux 커널 문서 — 전역 예산과 CPU별 slice.
100ms quota는 CPU들에게 어떻게 나뉠까요?
같은 cgroup의 스레드 T1~T3가 CPU0~2에서 실행됩니다. 단계를 누르면 그 시점에서 멈춥니다.
개념을 보여주는 모형입니다. 숫자는 예시이고, 전역 잔액이 5ms로 줄어드는 과정은 다른 CPU의 사용을 생략하고 줄여 그렸습니다. 어느 CPU가 먼저 잠금을 잡을지도 예시로 정했습니다. 실제로 가져오는 slice 크기는 설정과 전역 잔액에 따라 달라집니다.
CPU0~2가 100ms 예산을 가져가는 걸까요?
전역 quota에서 CPU별 실행 큐가 작은 몫을 받아 쓴다는 이해가 맞습니다. 하지만 100ms는 cgroup에 보장된 CPU 배정량이 아니라 그 기간에 사용할 수 있는 최대치입니다. 또한 그림의 CPU0~2는 virtual thread가 아니라 CPU의 논리적 실행 단위들입니다. 각각의 CPU에서 그 cgroup 소속 OS 스레드(T1~T3)가 실행되면 그 CPU의 해당 cgroup 실행 큐에 배정된 로컬 slice가 소모됩니다. virtual thread가 OS 스레드 위에서 실행된다면 커널의 CPU 사용량 계산에는 그 carrier OS 스레드의 실행 시간이 반영됩니다. 참고: Linux 커널 문서 — CPU별 실행 큐와 slice, Oracle 문서 — virtual thread와 carrier thread.
CPU0~2는 각 스레드의 전용 CPU일까요?
그림에서는 그 순간 T1, T2, T3가 각각 실행되고 있는 CPU라고 이해하면 됩니다. 그러나 스레드마다 전용 CPU가 고정 배정된다는 뜻은 아닙니다. 운영체제는 한 CPU에서 여러 스레드를 번갈아 실행할 수 있고, 스레드를 다른 CPU로 옮길 수도 있습니다. 그림의 5ms 역시 T1·T2·T3의 개인 예산이 아니라 그 CPU에 있는 해당 cgroup 실행 큐가 전역 quota에서 가져온 로컬 몫입니다. 참고: Linux 커널 문서 — CPU별 cgroup 실행 큐.
전역 quota와 CPU별 local slice
같은 cgroup의 스레드들은 하나의 전역 quota를 공유합니다. 각 CPU에 있는 그 cgroup의 실행 큐는 필요할 때 전역 quota에서 작은 로컬 slice를 받아, 해당 CPU에서 그룹의 스레드가 실행되는 동안 이를 소모합니다. 로컬 slice는 스레드 개인에게 고정 배정된 시간도, 전역 quota와 별도로 생긴 추가 시간도 아닙니다. 이를 “CPU 자원을 할당받는다”라고 말하면 사용이 보장되는 것처럼 들릴 수 있습니다. quota가 남았다는 것은 CPU 실행이 허용될 수 있다는 뜻이며, 실제로 언제 CPU를 쓸지는 스케줄러와 다른 실행 가능한 작업의 경쟁에 달려 있습니다. 참고: Linux 커널 문서 — 전역 quota와 CPU별 slice.
로컬 몫이 소진되면 전역 quota에서 다시 가져오기
커널은 실행 중인 작업의 CPU 사용 시간을 기록합니다. 해당 CPU의 cgroup 로컬 slice가 떨어지면 전역 quota에서 다음 몫을 받아 올 수 있는지 확인합니다. 전역에서도 받아 올 수 없고 실행할 작업이 남았다면, 그 그룹의 작업은 quota가 갱신될 때까지 throttle됩니다. 상위 cgroup의 quota가 바닥난 경우에도 실행이 제한될 수 있습니다. 참고: Linux 커널 문서 — CPU bandwidth control.
오해 바로잡기: 사용량 계산이 반드시 “user instruction 이후 syscall로 커널 모드에 진입할 때”에만 일어나는 것은 아닙니다. 커널은 스케줄러 틱이나 스케줄링 시점 등에도 실행 시간을 계산합니다. 사용자 코드가 시스템 호출을 전혀 하지 않고 CPU 계산만 계속해도 quota 제한을 피할 수는 없습니다. 참고: Linux 커널 문서 — 스케줄러의 CPU 사용 시간 계산.
local slice는 스레드마다 주어지거나 job 크기에 맞춰질까요?
둘 다 아닙니다. 여기서 local은 CPU별로 존재하는 해당 cgroup 실행 큐의 로컬 예산을 뜻합니다. 같은 CPU에서 그 cgroup의 서로 다른 스레드가 번갈아 실행되면 같은 로컬 몫을 사용할 수 있습니다. 커널은 job이 앞으로 CPU를 몇 ms 사용할지 미리 예측해서 한 번에 주지 않습니다. 그 CPU에서 그룹의 스레드가 실행 가능해질 때 전역 quota에서 slice라는 작은 조각을 필요에 따라 가져오고, 소모하면 다시 요청합니다. 기본 slice 크기는 5ms이지만 조정할 수 있고, 전역에 남은 양 등에 따라 실제로 가져오는 양은 더 작을 수 있습니다. 이 동작은 virtual thread의 작업 크기가 아니라 OS 스레드가 CPU에서 실행되는 시간을 기준으로 합니다. 참고: Linux 커널 문서 — CPU별 run queue에 slice 배분.
사용하지 않은 로컬 slice는 어떻게 되돌릴까요?
어떤 CPU에서 해당 cgroup의 실행 가능한 스레드가 없어지면, 그 CPU의 실행 큐가 보유한 로컬 slice의 사용하지 않은 부분 대부분을 전역 quota 풀로 돌려줄 수 있습니다. 그래야 다른 CPU가 그 예산을 쓸 수 있습니다. 다만 약 1ms까지는 그 CPU에 남겨 둘 수 있습니다. 나중에 같은 cgroup의 스레드가 그 CPU에서 다시 실행 가능해졌을 때 전역 풀에 곧바로 다시 접근하는 비용을 줄이기 위해서입니다. 예를 들어 5ms slice 중 2ms를 사용하고 3ms가 남았다면 개념적으로 2ms를 돌려주고 1ms를 로컬에 남겨 둘 수 있습니다. 이 1ms는 새로 생긴 추가 quota가 아니라 이미 전역에서 가져온 몫입니다. Linux 문서는 이 잔여 slice가 기간 경계에서 즉시 소멸하지 않는다는 점도 설명합니다. 참고: Linux 커널 문서 — CFS bandwidth quota caveats.
여러 CPU가 quota를 가져갈 때도 동시성 제어가 필요할까요?
필요합니다. 다만 전역 quota에서 몫을 직접 가져오는 주체를 스레드마다 하나씩으로 이해하면 부정확합니다. 같은 cgroup의 스레드들이 실행 가능해지면 각 CPU의 해당 cgroup 실행 큐가 필요에 따라 전역 quota에서 작은 slice를 받아 로컬로 보유합니다. 여러 CPU가 동시에 전역 잔액을 요청할 수 있으므로, 커널은 전역 잔액의 확인·차감을 잠금으로 보호해 같은 예산을 중복 배정하지 않습니다. 예를 들어 전역에 5ms만 남았는데 CPU0과 CPU1이 동시에 5ms씩 요청하면 둘 모두에게 5ms를 배정할 수 없습니다. 한 요청이 전역 잔액을 차감하면 다른 요청은 갱신된 잔액을 기준으로 처리됩니다.
그 뒤 각 CPU에서 스레드가 실행되며 소모하는 시간은 이미 받아 둔 로컬 slice에서 계산하므로, 매번 전역 잠금을 잡을 필요가 없습니다. slice 분배는 전역 잔액의 동시 갱신 비용을 줄이면서 중복 배정을 방지하는 방식입니다. 이는 다음 절에서 볼 DL·RT·FAIR의 실행 대상 선택과는 다른 문제입니다. 참고: Linux 커널 문서 — 전역 quota와 CPU별 slice, 전역 잠금 경합, Linux 커널 문서 — 로컬 slice의 재사용과 전역 잠금.
다음 OS 스레드는 어떤 큐에서 고를까요?
syscall 뒤에도 Thread A가 계속 실행될 수 있습니다
한 CPU에서 OS 스레드 A가 사용자 코드를 실행하다가 시스템 호출, 인터럽트, 예외 등의 이유로 커널 코드를 실행한다고 가정하겠습니다. 커널은 사용 시간을 기록하고, 다음 대상을 선택해야 한다면 CPU0의 rq0에서 실행 가능한 OS 스레드를 고릅니다. 커널 모드 진입만으로 스레드가 반드시 바뀌지는 않습니다.
- A가 계속 실행 가능하고 교체할 이유가 없으면 A의 사용자 코드로 돌아갑니다.
- A가 기다리게 되었거나 선점·quota 소진 등으로 다른 실행 대상이 필요하면 스케줄러가 실행 가능한 스레드를 고릅니다.
- 다른 대상 B가 선택됐다면 스레드 전환 후 B가 이어서 실행됩니다. B는 같은 cgroup의 스레드일 수도, 다른 cgroup의 스레드일 수도 있습니다. A의 cgroup이 throttled라면 그 cgroup의 실행이 제한됩니다.
여기서 rq0는 CPU0의 실행 대기열이고, cfs_rq는 그 안에서 fair scheduling 대상과 cgroup의 실행 시간을 관리하는 관련 실행 큐입니다. 이 목록은 가능한 경로를 나눈 것으로, 모든 커널 경로가 이 순서대로 진행된다는 뜻은 아닙니다. 사용 시간 계산도 syscall 때만 하는 것은 아닙니다. 참고: Linux 커널 문서 — 스케줄러의 CPU 사용 시간 계산, Linux 커널 문서 — cgroup CPU bandwidth control.
CPU별 rq 안에서 실행 대기열이 나뉘는 이유
CPU0의 rq
├─ dl_rq   D1, D2       (deadline)
├─ rt_rq   R1, R2, R3   (real-time)
└─ cfs_rq  A, B, C      (FAIR)
그림의 struct rq는 CPU0에 속한 실행 대기열의 전체 상태를 나타냅니다. 그 안에 작업의 스케줄링 종류에 따라 dl_rq(deadline), rt_rq(real-time), cfs_rq(fair/일반 작업) 같은 관련 대기열이 있습니다. D1·D2, R1·R2·R3, A·B·C는 각각 그 종류에서 실행을 기다리는 작업을 간단히 그린 것입니다.
다음 작업을 골라야 할 때 스케줄러는 그림에 표시된 종류들 사이에서 DL → RT → FAIR 순으로 실행 가능한 대상이 있는지 살핍니다. 선택된 종류 안에서는 그 종류의 스케줄링 규칙으로 구체적인 작업을 고릅니다. EEVDF는 FAIR 종류 내부의 선택과 관련되며, DL·RT·FAIR 사이의 우선순위를 정하는 규칙은 아닙니다.
이 도식은 개념을 위해 단순화했습니다. CPU마다 실행 대기열 상태가 있다는 뜻이지 CPU마다 완전히 독립된 스케줄러 프로그램이 하나씩 붙어 있다는 뜻은 아닙니다. 또한 실제 cfs_rq는 cgroup 등의 구성에 따라 여러 계층으로 나타날 수 있고, 그림에는 다른 스케줄링 종류도 생략되어 있습니다. 참고: Linux 매뉴얼 — 스케줄링 정책 간 우선순위, Linux 커널 문서 — EEVDF와 FAIR 스케줄링.
rq 안의 DL·RT·FAIR 대기열은 왜 나뉠까요?
rq는 run queue, RT는 real-time의 줄임말입니다. dl_rq, rt_rq, cfs_rq를 나눈 이유는 단순히 우선순위만 다르기 때문이 아닙니다. 클래스 간 선택 순서도 다르고, 같은 클래스 안에서 다음 작업을 고르는 기준과 관리해야 할 상태도 다르기 때문입니다. DL은 각 작업의 실행 시간·마감 시각·주기를 고려하고, RT는 실시간 우선순위 및 FIFO/RR 정책을 따르며, FAIR는 일반 작업들에 CPU 시간을 공정하게 나누는 데 초점을 둡니다. 예를 들어 DL 작업이 실행 가능하면 그림의 RT·FAIR보다 먼저 고려하지만, DL 작업끼리는 그 클래스의 규칙으로 다시 선택합니다. cfs_rq는 역사적인 구조체 이름이고, 최신 Linux의 FAIR 클래스는 EEVDF 방식으로 대상을 고릅니다. 참고: Linux 매뉴얼 — 정책별 스케줄링 규칙, Linux 커널 문서 — 스케줄링 클래스, Linux 커널 문서 — EEVDF.
EEVDF가 VT A에서 B로의 전환도 결정할까요?
Linux의 EEVDF는 일반적인 공정 스케줄링에서 실행 가능한 OS 스레드들 사이에 CPU를 배분하는 데 쓰입니다. 현재 스레드보다 앞선 가상 마감시간을 가진 스레드가 선점할 수 있습니다. 하지만 EEVDF가 “OS 스레드 안의 작업 A 대신 B를 실행하라”고 결정하는 것은 아닙니다. 또한 Linux의 모든 스케줄링 정책을 EEVDF 하나로 설명할 수는 없습니다.
참고: Linux 커널 문서 — EEVDF.
논리적 작업의 전환 기준은 실행 환경마다 다릅니다. 대표적으로 A가 I/O 결과를 기다리거나 스스로 실행을 양보하면, 그 상태를 보관하고 B를 실행할 수 있습니다. 어떤 실행 환경은 오래 실행하는 논리적 작업을 자체적으로 선점하기도 합니다. 예를 들어 Go의 goroutine에는 선점 메커니즘이 있습니다. 그래서 “논리적 작업은 반드시 기다릴 때에만 멈춘다”라고 일반화하면 안 됩니다.
참고: Go 실행 환경 소스 — goroutine 선점, Oracle 문서 — virtual thread의 대기와 재배치.
같은 job이 여러 클래스 큐에 동시에 들어갈까요?
정책을 바꾸면 T는 어디로 가고, CPU0은 누구부터 볼까요?
carrier OS 스레드 T의 정책을 바꿔 보고, CPU0이 다음 실행 대상을 고르게 해 보세요.
R1·F1·F2는 예시로 둔 다른 OS 스레드입니다. 정책 변경은 개념 실험이며, 실제 RT·DL 설정에는 권한과 정책별 매개변수·허용 조건이 필요합니다. 다른 스케줄링 클래스와 cgroup 계층 큐는 생략했습니다.
그림의 D1, R1, A 등을 커널이 스케줄링하는 OS 스레드 하나로 읽는다면, 같은 스레드가 동시에 여러 클래스 큐의 후보가 되지는 않습니다. 각 스레드에는 그 시점의 스케줄링 정책이 하나 있고, 그에 맞는 클래스에서 다뤄집니다. 정책을 바꾸면 소속 클래스도 바뀌는 것이지, 기존 클래스와 새 클래스에 동시에 복제되는 것은 아닙니다. CPU를 옮기는 경우에도 하나의 스레드가 여러 CPU에서 동시에 실행되는 것은 아닙니다.
다만 애플리케이션에서 말하는 job(논리적인 일)은 OS 스레드 하나와 같지 않을 수 있습니다. 하나의 job을 여러 OS 스레드로 나눠 수행하고 그 스레드들의 정책이 다르다면, 같은 job에 기여하는 서로 다른 스레드들이 서로 다른 클래스에서 관리될 수 있습니다. virtual thread 같은 런타임 작업 자체는 커널의 이 큐에 직접 들어가지 않고, 이를 실행하는 OS 스레드가 스케줄링 대상입니다. 참고: Linux 매뉴얼 — 스레드마다 스케줄링 정책이 있음, Linux 매뉴얼 — 스레드의 정책 설정.
스레드는 DL·RT·FAIR 점수를 모두 계산해 큐를 고를까요?
아닙니다. 여기서 job을 OS 스레드 하나와 같다고 가정하면, 각 스레드에는 한 시점에 적용되는 스케줄링 정책 하나가 있습니다. 그 정책에 따라 DL·RT·FAIR 중 해당 클래스에서 관리됩니다. 일반적인 스레드는 기본 정책인 SCHED_OTHER에 따라 FAIR에서 관리됩니다. RT 정책(SCHED_FIFO 또는 SCHED_RR)으로 설정된 스레드는 RT에서, SCHED_DEADLINE으로 설정된 스레드는 DL에서 다룹니다. 세 클래스의 값을 모두 계산한 뒤 최댓값을 골라 넣는 방식이 아닙니다.
각 클래스가 사용하는 값도 서로 다릅니다. DL은 실행 시간·마감 시각·주기, RT는 해당 정책과 실시간 우선순위, FAIR는 일반 작업의 상대적 배분에 쓰이는 nice/weight 등을 고려합니다. 앞서 배운 cgroup의 cpu.weight는 그룹 간 상대적 CPU 배분 설정이므로, OS 스레드마다 DL·RT·FAIR 가중치 세 개를 갖는다는 뜻이 아닙니다. 큐에 들어갈 때의 정책 선택과 다음 실행 대상을 고를 때의 클래스 우선순위를 구별합니다. 참고: Linux 매뉴얼 — 스레드별 정책과 속성, Linux 매뉴얼 — sched_setattr의 정책별 필드, Linux 커널 문서 — cgroup cpu.weight.
OS 스레드의 스케줄링 정책은 어떻게 정해질까요?
보통 프로그램이 실행될 때의 일반 스레드는 SCHED_OTHER 정책을 사용합니다. 그 스레드가 새 POSIX 스레드를 만들면, 기본 생성 설정에서는 새 스레드가 생성자의 스케줄링 정책과 매개변수를 상속합니다. 예를 들어 FAIR에서 관리되는 스레드가 기본 설정으로 새 스레드를 만들면 새 스레드도 FAIR 대상입니다. 프로그램이 새 스레드를 만들 때 명시적인 스케줄링 속성을 지정할 수도 있고, 생성한 뒤 pthread_setschedparam() 또는 Linux의 sched_setattr() 같은 인터페이스로 정책을 바꿀 수도 있습니다. RT·DL 정책을 설정할 때는 해당 정책의 매개변수와 권한·제약 조건을 충족해야 합니다.
커널은 각 스레드에 정해진 정책을 보고 대응하는 스케줄링 클래스에서 관리합니다. 스레드가 실행 가능한 상태가 되어 CPU를 기다릴 때 그 클래스의 실행 후보가 되고, 정책이 바뀌면 적용 클래스도 바뀝니다. 작업의 코드, 실행 시간, 중요도를 커널이 자동 분석해 DL·RT·FAIR 중 최고 점수를 받은 큐에 넣는 것은 아닙니다. 클래스 간 우선순위는 그 뒤에 다음 실행 스레드를 고를 때 쓰입니다. 참고: Linux 매뉴얼 — 스레드 정책과 일반 정책, Linux 매뉴얼 — 새 스레드의 정책 상속 또는 명시 설정, Linux 매뉴얼 — 스레드 정책 변경, Linux 매뉴얼 — deadline 정책 설정.
스케줄링 정책은 언제 설정될까요?
- 프로그램 시작 전후: Linux에서 새 프로세스를 만들면 보통 만든 쪽의 스케줄링 정책을 이어받고, 새 프로그램을 실행하는
execve()를 거쳐도 그 정책은 유지됩니다. 일반적인 시작 환경에서는SCHED_OTHER인 경우가 많습니다. 특별한reset-on-fork설정 등 예외가 있습니다. - OS 스레드 생성 시: POSIX 스레드의 기본 생성 설정은 생성한 스레드의 정책을 상속합니다. 프로그램은 생성 속성을 명시해 다른 정책을 요청할 수도 있습니다.
- 이미 실행 중일 때: 프로그램이나 권한 있는 관리자가 해당 스레드의 정책을 바꿀 수 있습니다. 예를 들어
pthread_setschedparam()또는 Linux의sched_setattr()을 사용합니다.
따라서 정책은 큐에 넣기 직전에 매번 새로 계산하는 값이 아닙니다. 스레드에 현재 설정된 정책이 있고, 그 스레드가 실행 가능해지면 해당 스케줄링 클래스의 후보로 다뤄집니다. 정책을 바꾸면 관리되는 클래스도 바뀝니다. 참고: Linux 매뉴얼 — fork 상속 및 execve 유지, Linux 매뉴얼 — 스레드 생성 시 상속/명시 설정, Linux 매뉴얼 — 실행 중 정책 변경.
기본 스케줄링 정책은 어디에서 올까요?
일반적인 프로그램 개발에서는 매번 스레드의 정책을 직접 지정하지 않습니다. Linux가 일반 작업의 기본 정책으로 SCHED_OTHER를 제공하고, 새 프로세스는 보통 자신을 시작한 부모 프로세스의 정책을 이어받습니다. 새 프로그램을 실행하는 execve()도 Linux에서는 그 정책을 유지합니다. 새 POSIX 스레드 역시 기본 생성 설정에서 생성한 스레드의 정책을 상속합니다. 그래서 보통 SCHED_OTHER인 실행 환경에서 시작한 프로그램의 스레드들이 계속 SCHED_OTHER를 쓰는 것입니다. 특정 프로그램을 시작하는 관리자나 프로그램 코드가 정책을 명시적으로 바꾸면 그 흐름이 달라질 수 있습니다. 이는 스레드마다 커널이 항상 SCHED_OTHER를 새로 덮어쓴다는 뜻이 아닙니다. 참고: Linux 매뉴얼 — SCHED_OTHER 기본 정책, fork 상속, execve 유지, Linux 매뉴얼 — 새 스레드 정책의 기본 상속.
커널 모드에 들어갔다고 곧바로 스레드가 바뀌지는 않습니다
rq는 각 논리 CPU의 실행 대기열 상태이고, 해당 CPU에서 실행할 수 있는 OS 스레드 후보를 스케줄링 클래스별로 관리합니다. 스케줄러가 다음 실행 대상을 골라야 할 때는 더 우선하는 클래스에서 실행 가능한 대상이 있는지 확인하고, 선택한 클래스의 규칙으로 구체적인 스레드를 고릅니다. 따라서 “CPU 코어마다 스케줄러가 달려 있다”는 표현은 CPU별 대기열과 스케줄링 상태가 있다는 뜻으로 읽는 것이 정확합니다. 각 CPU에 완전히 별개의 스케줄러 프로그램이 설치되어 있다는 뜻은 아닙니다.
또 “스레드가 커널 모드로 진입 시에 rq를 훑는다”는 표현은 매번 그렇게 한다는 뜻으로 받아들이면 잘못됩니다. 시스템 호출 등으로 커널 모드에 들어와도 현재 스레드가 계속 실행될 수 있습니다. 다음 대상을 골라야 하는 상황(예: 현재 스레드가 대기 상태로 바뀌거나 선점이 필요한 경우)에 스케줄러의 선택 절차가 수행됩니다. 커널 모드 진입은 스케줄링이 일어날 수 있는 계기 중 하나일 뿐입니다. 참고: Linux 커널 문서 — 스케줄링 클래스와 pick_next_task, Linux 커널 문서 — 스케줄링 이벤트와 선점.
VT와 Linux 스케줄러를 다시 함께 보면
VT도 Linux의 실행 대기열에 들어갈까요?
지금까지 따라온 범위는 크게 (1) 커널이 OS 스레드의 실행 순서를 정하는 스케줄링 클래스/정책과 (2) cgroup이 CPU quota를 계산·배분·제한하는 방식입니다. 둘은 함께 작동하지만 같은 개념은 아닙니다.
Java virtual thread(VT)에는 한 단계가 더 있습니다. Java 런타임이 실행할 VT를 골라 carrier(플랫폼/OS 스레드)에 올리고, Linux 커널은 그 carrier OS 스레드를 자신의 스케줄링 클래스와 CPU별 rq에 따라 CPU에 배정합니다. 일반적인 FAIR carrier가 cgroup에 속한다면, cgroup의 cpu.max quota 및 CPU별 slice가 그 carrier OS 스레드의 실행 시간에 적용됩니다. VT 각각이 Linux의 dl_rq·rt_rq·cfs_rq에 들어가거나 각자 별도의 quota slice를 가져오는 구조는 아닙니다. VT의 Java Thread 우선순위도 고정 NORM_PRIORITY이며 변경 요청이 적용되지 않습니다.
따라서 “실행 대상을 골라 더 적은 실행 자원에 배치한다”는 큰 그림은 비슷하지만 JVM의 VT 스케줄러와 Linux의 OS 스레드 스케줄러는 서로 다른 층입니다. Java VT는 보통 블로킹 작업 등에서 carrier에서 내려오며 다른 VT가 그 carrier를 사용할 수 있습니다. OpenJDK의 VT 스케줄러는 OS 스레드처럼 VT에 일정 CPU 시간마다 강제 시분할을 적용하지 않는다고 설명합니다. 참고: Oracle — VT와 carrier의 스케줄링, OpenJDK JEP 444 — M:N과 VT 스케줄링, Oracle — VT 우선순위, Linux 커널 — cgroup quota와 CPU별 slice.
누가 무엇을 고르고, 어디서 제한할까요?
앞에서 하나씩 떼어 본 결정을 한 흐름으로 이어 봅니다. 단계를 누르면 그 시점에서 멈춥니다.
실행 경로를 보여주는 개념 모형입니다. quota 숫자는 예시이고, 전역 quota가 바닥나는 과정은 다른 CPU의 사용을 생략하고 줄여 그렸습니다. 실제 cgroup 계층, 잔여 slice 반환, 커널의 정산 시점은 생략했습니다.
참고 자료
- Linux
clone(2)— 프로세스·스레드의 공유 자원 - OpenJDK JEP 444 — Virtual Threads
- Oracle — Virtual Threads와 carrier
- Linux 커널 — cgroup v2의 CPU 제어
- Linux 커널 — CFS bandwidth control과 CPU별 slice
- Linux
sched(7)— 스레드의 스케줄링 정책 - Linux 커널 — EEVDF
썸네일 사진: Jonathan Borba / Unsplash