다섯 서비스가 한 데이터베이스를 썼습니다
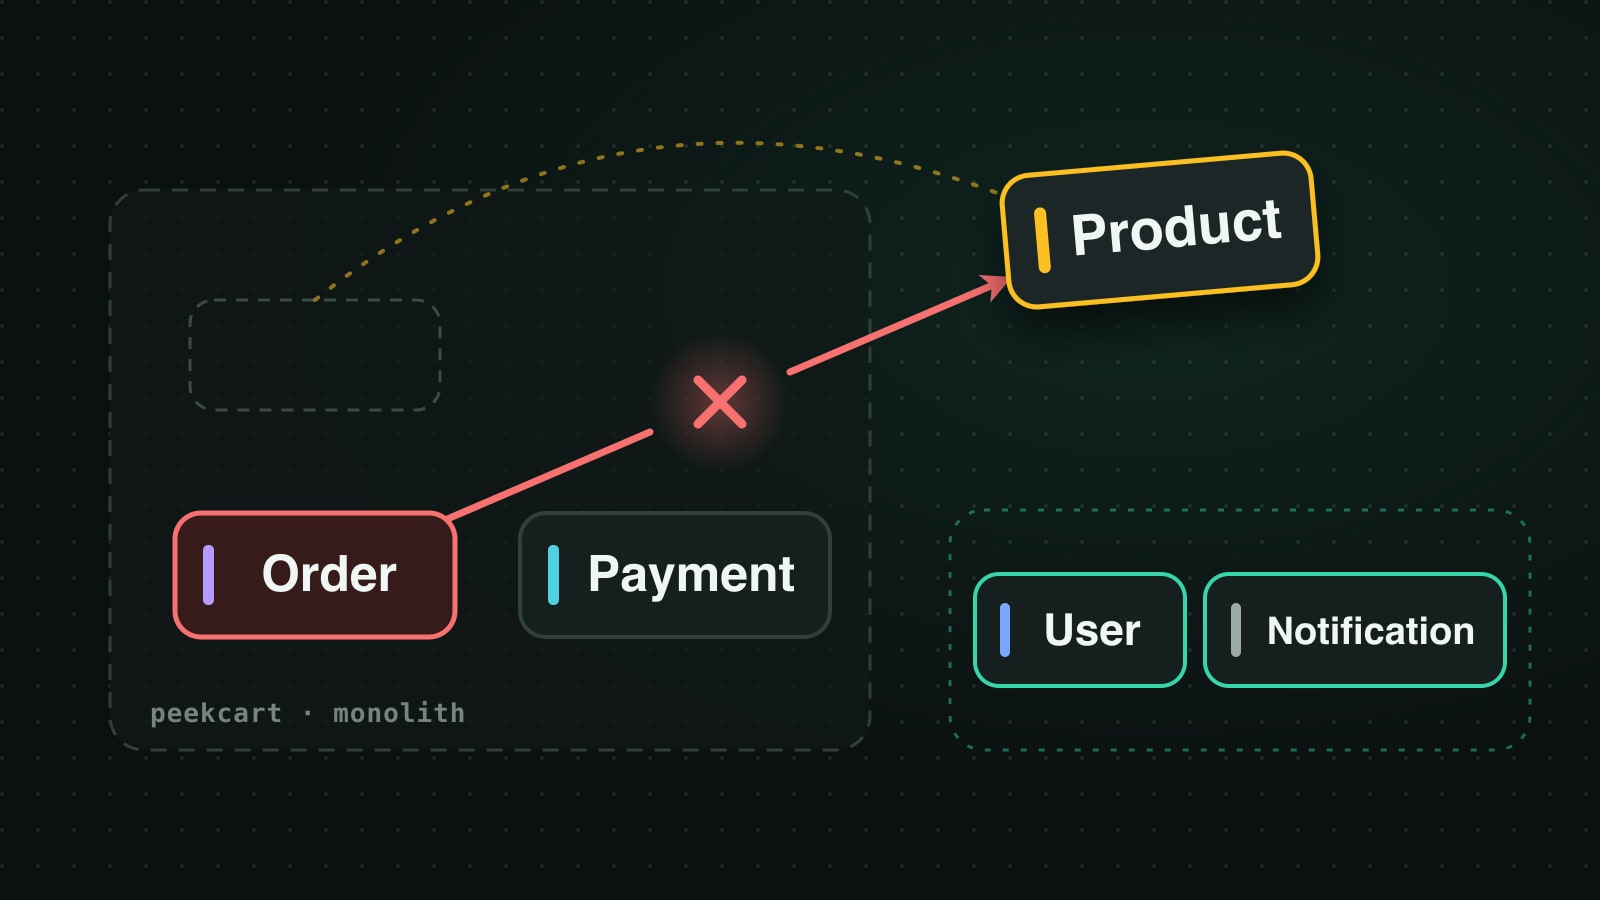
PeekCart를 다섯 서비스로 분리한 직후, 이미지와 Deployment는 각각 다섯 개였지만 모든 서비스가 jdbc:mysql://mysql:3306/peekcart에 peekcart 계정으로 접속했습니다. 코드의 서비스 경계와 데이터의 소유 경계가 다른 상태였습니다.
공유 DB를 유지하는 동안 네 가지 임시 구조가 필요했습니다.
| 임시 구조 | 공유 DB와의 관계 |
|---|---|
| order-service만 Flyway 실행 | 마이그레이션 이력이 하나라 다른 서비스는 Flyway를 끄고 스키마만 검증했습니다. |
| 다른 네 서비스의 initContainer가 order-service를 기다림 | 스키마를 만든 뒤에야 각 서비스가 검증을 통과할 수 있었습니다. |
| CI smoke가 앱보다 먼저 Flyway 이미지로 스키마 적용 | 빈 DB에서 Flyway를 끈 서비스가 먼저 뜨지 못했습니다. 기존 Gradle 태스크도 깨져 있어 우회했습니다. |
| outbox poller의 이벤트 종류 allowlist | 발행 서비스가 한 outbox_events 테이블을 공유하므로 자기 이벤트만 골라야 했습니다. |
누가 먼저 떠야 했을까요?
다섯 서비스를 동시에 배포해 보세요. 공유 DB에서는 스키마를 만드는 서비스가 하나뿐이라, 나머지는 그 서비스를 기다립니다.
순서와 기다림만 보여주는 모형입니다. 막대나 패킷의 시간 길이는 실제 기동 시간을 측정한 값이 아닙니다. 네 임시 구조 중 CI의 Flyway 선적용과 outbox allowlist는 그리지 않았습니다.
이 구조에서는 기동 순서와 테이블 내용에 서비스 간 의존이 남아 있었습니다. 그래서 독립 배포 경계가 아직 완성되지 않았다고 해석했습니다.
공유 DB에는 도메인을 가로지르는 외래 키(FK)도 여섯 개 있었습니다.
| FK | 자식 → 부모 |
|---|---|
fk_carts_user | carts.user_id → users.id |
fk_cart_items_product | cart_items.product_id → products.id |
fk_orders_user | orders.user_id → users.id |
fk_order_items_product | order_items.product_id → products.id |
fk_payments_order | payments.order_id → orders.id |
fk_notifications_user | notifications.user_id → users.id |
여섯 제약에는 ON DELETE 절이 없었습니다. MySQL 8.0 문서에 따르면 기본 동작은 NO ACTION이며 InnoDB에서는 RESTRICT와 같습니다. 이 제약은 부모가 없는 자식 행의 삽입과, 자식이 참조하는 부모 행의 삭제를 막습니다. 서비스를 서로 다른 스키마로 나누면서 교차 FK를 제거하면 이 DB 수준의 보장도 사라집니다.
따라서 분리 전에 세 질문에 답해야 했습니다. FK가 막던 일을 무엇이 대신하는가? 어디까지를 데이터베이스 경계로 삼을 것인가? 이벤트 처리 기록은 얼마나 남겨야 하는가?
FK를 지우기 전에 무엇을 확인했을까요?
기존 설계(ADR-0012)는 각 서비스의 단독 데이터 소유, 교차 FK 제거, ID 참조와 이벤트·로컬 캐시, 서비스별 마이그레이션 이력을 정했습니다. processed_events와 outbox_events를 정리하는 일도 남아 있었습니다. 계획은 FK 제거 → 스키마 분리 → 정리 잡 추가의 세 PR로 나눴습니다. 서비스별 다섯 PR과 공통 작업 하나로 나누는 방식은 MySQL 초기화, CI, Gradle 같은 공유 인프라를 증분 전환하기 어색해 기각했습니다.
FK를 걷어 내면 무엇이 달라질까요?
요청을 보내 보고, 교차 FK를 걷어 낸 뒤 같은 요청을 다시 보내 보세요. 어느 관문에서 무엇이 걸리는지 보면 됩니다.
③은 서비스 코드를 거치지 않는 쓰기(예: 수동 SQL)가 있을 때 DB 수준 보장이 무엇을 하는지 보여주려고 넣은 가상의 요청입니다. 글의 작업에서 이런 쓰기가 있었다는 뜻은 아닙니다. 사용자 ID 경로(토큰)와 결제·알림의 이벤트 경로, 이벤트 지연은 그리지 않았습니다.
먼저 여섯 FK의 자식 ID가 어디에서 오는지 확인했습니다.
| 자식 ID | 당시 코드의 입력 경로 |
|---|---|
carts.user_id, orders.user_id | 요청 본문 대신 검증된 토큰의 사용자 ID(@CurrentUser LoginUser)를 사용했습니다. 다만 토큰만으로 현재 users 행의 존재까지 증명되지는 않습니다. 사용자 삭제 경로가 없다는 사실을 함께 봐야 합니다. |
cart_items.product_id, order_items.product_id | Order의 상품 단가 캐시에서 찾습니다. 없으면 각각 ORD-009, ORD-007로 거절합니다. 캐시는 product.updated 이벤트로 채웁니다. |
payments.order_id | Payment가 order.created를 소비할 때 결제 행을 만듭니다. |
notifications.user_id | 소비한 이벤트의 사용자 ID를 사용합니다. |
이 경로들은 부모 없는 ID를 넣지 않도록 하는 애플리케이션 쪽 대체 수단입니다. 다만 이벤트 지연이나 캐시 미수신까지 DB의 FK처럼 즉시 막는다는 뜻은 아닙니다. 교차 FK를 제거한 뒤에는 고아 참조의 정합성이 애플리케이션과 이벤트 처리에 달려 있습니다.
부모 삭제 경로도 당시 코드 기준으로 살펴봤습니다. users와 orders의 삭제 경로는 없었고, 상품 삭제 API는 행을 지우는 대신 상태를 DISCONTINUED로 바꾸고 product.updated를 발행했습니다. 따라서 FK의 두 번째 보장은 걸려 있었지만 실제로 발동할 삭제 경로는 없었다고 볼 수 있습니다. PR1에서는 DB 수준의 교차 FK를 중복 안전장치로 보고 제거했습니다.
FK만 먼저 제거하고 ID 컬럼과 같은 도메인의 FK는 남겼습니다. 공유 DB 상태에서 애플리케이션 테스트를 돌릴 수 있어, 이후 스키마 분리와 변경 범위를 나누는 체크포인트가 됐습니다. 테스트가 통과했다는 사실은 그 범위에서 FK 의존 회귀가 드러나지 않았다는 뜻이지, 모든 비동기 정합성을 증명한 것은 아닙니다.
스키마 분리 전에 무엇을 다시 정했을까요?
초기 계획에서 바뀐 테이블 소유
스키마별 베이스라인을 만들려면 각 테이블의 주인을 정해야 합니다. ADR-0012를 쓸 때 예상한 모델은 서비스를 분리하며 Product와 Payment에서 바뀌었습니다. 이번 DB 분리에서는 바뀐 구현을 기준으로 소유 테이블을 정했습니다.
| 서비스 | 초기 계획(ADR-0012) | 서비스 분리 후 구현 |
|---|---|---|
| Product | inventories에 예약 컬럼 추가 | 예약 상태를 별도 stock_reservations 테이블에서 관리 |
| Payment | payment_failures 테이블 예정 | payment_failures는 만들지 않고 payment_cancellations를 추가 |
재고 예약은 처음에 단순한 컬럼 방식을 택했습니다. 이후 이벤트 기반 예약을 구현하면서 processed_events만으로는 취소 이벤트가 예약보다 먼저 오는 경우나 서로 다른 eventId의 이중 해제를 막을 수 없었습니다. 그래서 주문 ID 단위로 상태를 추적하는 예약 테이블을 만들었습니다. 결제 쪽에는 결제 시작보다 주문 취소가 먼저 올 때 결제를 막기 위해 payment_cancellations가 생겼습니다. 초기 계획의 payment_failures를 이름만 바꾼 것은 아닙니다.
이 변화를 ADR에 어떻게 반영할지도 정해야 했습니다. 프로젝트 규칙은 사실 오류를 Update Log로 고치되 결정 변경은 새 ADR로 남기도록 합니다. 처음에는 둘 다 Update Log로 고칠 생각이었고, 다음 리뷰에서는 예약 모델만 새 ADR 대상으로 봤습니다. PR2 착수 전 재검토에서 결제 테이블도 목적이 바뀐 결정으로 판정했습니다. 최종적으로 ADR-0016을 만들고 ADR-0012의 Product·Payment 소유표와 예약 모델만 Partially Superseded로 표시했습니다. 원래 ADR의 경계 원칙까지 전부 대체하면 유효한 결정을 불필요하게 버리게 됩니다. 대신 두 ADR을 함께 읽어야 하는 비용이 남았습니다.
공통 마이그레이션과 빈 데이터베이스
공유 이력은 V1부터 V13까지였습니다. V1이 모든 도메인 테이블을 만들고, V7은 Order의 product_price_cache를 채우려고 Product의 products를 읽습니다. 따라서 파일을 서비스별로 필터링해 옮기면 교차 도메인 SQL을 빠뜨리거나 잘못 남길 위험이 있었습니다.
서비스마다 최종 테이블 상태를 담은 V1__init_<svc>.sql 하나를 새로 만들었습니다. 개별 ALTER 이력은 새 스키마에서 보이지 않게 되지만, 보존할 운영 데이터가 없는 그린필드 환경이어서 그 대가를 받아들였습니다. 개발·테스트 데이터는 폐기하고 빈 스키마에서 시작했습니다. 롤백은 PR2를 되돌리고 볼륨을 다시 초기화하는 방식입니다. 기존 데이터를 옮기는 절차를 검증한 사례는 아닙니다.
V7의 교차 테이블 복사는 베이스라인에서 뺐습니다. 단가 캐시는 이후 product.updated로 채워집니다. 다른 도메인의 부모 행을 실제로 넣던 통합 테스트도 임의 ID 참조로 바꿨습니다.
정리 코드가 없는 보존 기간
착수할 때 processed_events와 outbox_events를 정리하는 스케줄러는 없었습니다. processed_events의 행은 같은 이벤트를 다시 받았을 때 처리 여부를 알려 줍니다. 너무 일찍 지우면 Kafka 재전달, 중단된 consumer의 재개, DLQ 재처리, 운영 backfill에서 같은 eventId를 다시 처리할 수 있습니다. 이 네 경로는 설계의 네 하한 항을 독자가 이해하기 쉽게 풀어 쓴 설명입니다.
ADR-0012의 조건은 processed_events 보존 기간이 Kafka 토픽 보존 기간, 최대 consumer 중단 시간, DLQ 재처리 창, backfill 창의 최댓값 이상이어야 한다는 것이었습니다. 당시에는 숫자와 이를 강제할 코드가 없었습니다. 토픽 보존 기간도 애플리케이션 설정과 자동 연결되지 않아 수동으로 대조해야 했습니다.
어떤 경계를 선택했을까요?
한 인스턴스, 다섯 스키마
ADR-0012는 데이터의 단독 소유만 정했고 MySQL 인스턴스 수는 정하지 않았습니다. 아래의 얻는 것·잃는 것 비교는 글을 쓰며 정리한 것이며, 당시 검토 표가 아닙니다.
| 배치 | 얻는 것 | 잃는 것 |
|---|---|---|
| 인스턴스 5개 | 장애 도메인을 분리할 수 있습니다. | 인스턴스마다 CPU·메모리·디스크가 듭니다. |
| 인스턴스 1개, 스키마·계정 각 5개 | 소유권, 권한, Flyway 이력을 서비스별로 나눌 수 있습니다. | 장애 도메인은 하나입니다. |
PeekCart는 두 번째를 골랐습니다. 당시 학습 목표는 논리적 소유 경계였고, MySQL 다섯 개를 4코어 minikube와 GKE e2-standard-4 노드 한 대에 띄우기는 빠듯하다고 봤습니다. 당시 MySQL 한 개의 요청량은 CPU 250m·메모리 512Mi, 한도는 500m·1Gi, PVC는 1Gi였습니다. 인스턴스 분리는 나중에 서비스별 datasource URL을 바꾸는 후속 선택으로 남겼습니다.
보존 기간을 부팅 조건으로
보존 기간은 경고만 남겨서는 잘못된 설정의 배포를 막지 못합니다. 리뷰에서 초기의 ‘실패 또는 경고’ 안을 버리고, 하한 위반 시 부팅 실패로 결정했습니다. 다섯 설정 필드의 관계를 서비스마다 중복 구현하지 않도록 공통 typed properties에 @AssertTrue 검증을 뒀습니다.
@AssertTrue
public boolean isRetentionAtLeastFloor() {
    return retention != null && retention.compareTo(floor.max()) >= 0;
}
당시 규칙은 retention ≥ max(네 창)입니다. 설정 바인딩 때 검증하므로 하한보다 짧으면 애플리케이션 컨텍스트가 뜨지 않습니다. 테스트에서도 보존 기간 7일은 기동 성공, 1일은 기동 실패로 확인했습니다.
정리 잡은 당시 테이블을 가진 모듈에만 뒀습니다. processed_events는 product·order·payment·notification, outbox_events는 product·order·payment에 있었습니다. user-service에는 잡과 하한 검증이 없었습니다. 조건부 활성화 설정 대신 클래스의 물리적 배치로 이 구성을 만들었습니다. 이후 notification에도 outbox가 생겼고 잡 클래스는 공유 메시징 모듈로 옮겨졌습니다. 여기의 배치는 PR3 당시를 설명합니다.
삭제는 실행 시작 때 cutoff를 한 번 계산하고, 500건씩 최대 20묶음으로 나누며, 묶음마다 트랜잭션을 분리했습니다. 삭제 기준 컬럼에도 인덱스를 추가했습니다. 큰 단일 DELETE의 긴 락과 트랜잭션, 다음 스케줄과의 중첩, consumer의 기록 경로 간섭을 피하려는 선택입니다. outbox는 status = 'PUBLISHED' AND published_at < cutoff인 행만 지웁니다. 리뷰에서 PENDING, FAILED, 발행 시각이 없는 행이 유실되지 않도록 조건을 고정했습니다. 보존 기간이 지난 이벤트의 동일 eventId 재처리는 보장 범위 밖이므로 새 eventId 발행이나 운영자 중복 확인 절차가 필요합니다.
세 PR 뒤에 무엇이 달라졌을까요?
| PR | 변경과 확인 |
|---|---|
| PR1 (#69) | V13__drop_cross_domain_fks.sql로 교차 FK 6개만 제거했습니다. 교차 도메인 엔티티 매핑은 0건이었고, 네이티브 쿼리는 Order의 자기 product_price_cache만 사용했습니다. 전체 빌드와 테스트가 통과했습니다. |
| PR2 (#71) | 스키마와 계정을 각각 다섯 개 만들고 각 서비스가 자기 Flyway 이력을 갖게 했습니다. 공유 마이그레이션과 선적용 단계를 제거했습니다. 전체 빌드와 테스트 및 교차 도메인 테스트 시드 제거를 확인했습니다. |
| PR3 (#72) | 정리 잡과 보존 기간 하한 검사를 추가했습니다. 기동 성공·실패, 삭제 조건·배치, 정책 설정 위치, 서비스별 잡 배치에 대한 테스트를 통과했습니다. |
테이블이 주인을 찾아갑니다
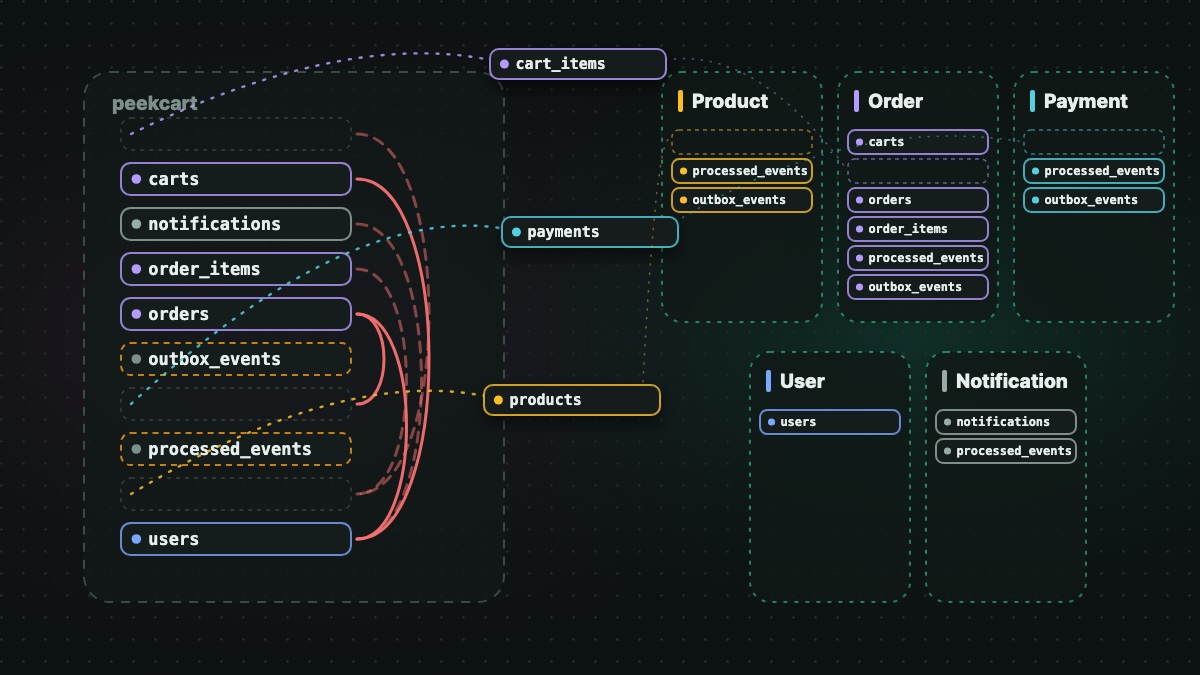
단계를 눌러 같은 테이블을 따라가 보세요. 한 스키마에 알파벳순으로 섞여 있던 테이블이 FK를 걷어 낸 뒤 주인 스키마로 옮겨 갑니다.
FK에 걸린 테이블과 이벤트 기록 테이블만 그렸습니다. inventories, stock_reservations, product_price_cache, payment_cancellations와 Flyway 이력 테이블은 생략했습니다. PR3 당시 구성이라 이후 생긴 notification outbox는 없습니다. 다섯 스키마는 모두 같은 MySQL 인스턴스 안에 있습니다. 스키마 권한 격리를 실행으로 검증했다는 뜻은 아닙니다.
스키마를 초기화할 때는 Secret 환경 변수의 서비스별 비밀번호로 계정을 만들고, 해당 스키마에만 권한을 부여하도록 했습니다. 비밀번호를 ConfigMap의 SQL에 그대로 넣는 초기안은 리뷰에서 바뀌었습니다. DROP도 처음 GRANT에 들어 있었다가 최소 권한을 위해 제거했습니다. 핵심 권한 범위는 다음 한 줄입니다.
GRANT SELECT, INSERT, UPDATE, DELETE, CREATE, ALTER, INDEX, REFERENCES ON `peekcart_order`.* TO 'peekcart_order'@'%';이 구성은 다른 스키마 접근을 거부하도록 설계됐습니다. 다만 그 거부가 실제로 일어나는지는 별도 실행 검증이 필요합니다. 분리 후에는 order-service만 Flyway를 돌리던 구조, 다른 서비스의 대기 initContainer, CI의 선적용, outbox 종류 allowlist도 제거됐습니다.
PR3 당시 네 서비스의 processed_events 보존 기간은 7일이었습니다. 하한 입력은 Kafka 토픽 7일, 최대 consumer 중단 24시간, DLQ 재처리 7일, backfill 7일이었습니다. outbox 보존 기간도 7일이고, 배치 크기는 500건·최대 20묶음이었습니다. 당시 Kafka 토픽의 retention.ms를 조회해 604800000(7일)과 설정을 대조했습니다. consumer 중단과 backfill 등의 값은 운영 측정치가 아니라 Kafka 보존 기간을 넘지 않게 둔 가정값입니다. 부팅 검사는 입력값들 사이의 관계만 확인하며 실제 토픽 값과 자동으로 대조하지 않았습니다. 현재 processed_events 보존 기간은 9일입니다.
이후 GKE의 up=5, 앱 계정의 TRUNCATE 권한 오류(1142), e2e의 스키마별 Flyway 버전 대조는 소유 경계가 나뉜 간접 증거입니다. 다른 스키마 접근 거부와 스키마 간 FK 0은 확인된 결과가 아닙니다. 한 MySQL 인스턴스를 공유하므로 장애 도메인도 하나로 남았습니다.
더 좋은 방법은 없었을까요?
여기부터는 작업 당시 검토한 대안이 아니라 이후 결정과 측정을 바탕으로 한 사후 분석입니다.
7일과 7일이 같아도 안전했을까요?
PR3 규칙은 retention ≥ max(네 창)이어서 retention: 7d와 dlq-replay-window: 7d를 통과시켰습니다. PR3 이후 ADR-0020은 서비스 로컬 시각의 오차와 하루 한 번 도는 정리 잡의 시간 여유가 그 등호에 없다고 지적했습니다. 7일 끝의 재처리를 보장하려면 시계 오차 5분과 정리 안전 여유 1일을 더해야 한다는 결론입니다.
7d(DLQ 창) + 5m(시계 오차 예산) + 1d(정리 안전 예산) = 8d 5m이므로 현재 보존 기간은 9일입니다. 새 규칙에 당시 7일 값을 넣으면 부팅이 실패해야 합니다. PR3에서 정리 주기까지 하한에 반영할 수도 있었겠다는 사후 판단이 남습니다.
7일과 7일 사이, 5분을 확대해 보면
9일 축에서는 보이지 않는 차이를 렌즈로 키웠습니다. 정리 잡의 시계를 조금 앞당긴 뒤 창 끝에서 재처리를 보내 보세요.
시계 오차는 정리 잡의 시계가 앞선 경우 하나만 모형으로 그렸습니다. 정리 안전 예산 1일은 ADR-0020 규칙의 항으로만 표시했고, 그 근거가 되는 정리 주기의 동작은 그리지 않았습니다. 실제 중복 처리 빈도는 측정하지 않았고, Kafka 토픽 설정과 하한 입력값의 일치 여부도 이 장면에서는 다루지 않습니다.
토픽 설정과 판정 SQL
PR3의 Kafka 하한 입력은 수동 선언값이었습니다. ADR-0020은 업무 토픽과 .dlq 토픽의 NewTopic에 retention.ms를 명시하고 하한 입력과 같은 출처에서 값을 가져오도록 정했습니다. 그렇더라도 기존 토픽에는 선언만으로 설정이 적용되지 않습니다. ADR-0020이 확인한 KafkaAdmin.modifyTopicConfigs의 기본값이 false여서 적용 경로는 별도로 필요합니다. PR3 때 값을 한 출처로 묶었더라도 이 적용 문제는 남았을 것이라는 해석입니다.
PR2의 수동 판정 SQL을 CI에 넣었다면 격리 여부를 반복 확인할 수 있었을 것입니다. 이후 e2e 하네스에는 서비스별 계정 접속 함수가 생겼습니다. 이를 이용한 다른 스키마 SELECT 거부 검사와 스키마 간 FK 검사는 제안이며, 현재 실행된 검사는 아닙니다.
인스턴스 하나의 대가
Database per service 패턴은 테이블·스키마·DB 서버를 서비스별로 나누는 방식을 제시하며, 스키마별 분리가 소유권을 분명하게 하면서 오버헤드가 낮은 선택지라고 설명합니다. 서버별 분리는 처리량이 큰 서비스에 필요할 수 있다고도 합니다. 원문에는 Database-server-per-service – each service has it's [sic] own database server.라고 적혀 있습니다.
PeekCart의 이후 주문 생성 경로 측정에서 MySQL은 CPU 한도 500m 중 498m를 썼습니다. 한도를 2000m로 올리자 처리량은 초당 54건에서 158.6건(약 2.94배), p95는 2.38초에서 879ms로 바뀌었습니다. 이 측정 등을 근거로 읽기 경로 측정도 함께 고려한 ADR-0027에서 기본 MySQL CPU 한도를 2000m로 올렸습니다. 이 결과는 500m 한도가 병목이었다는 증거이며, 인스턴스를 다섯 개로 나눴을 때의 결과를 측정한 것은 아닙니다. 각각 500m로 나눠도 비슷한 한도에 닿았을 것이라는 생각은 추론에 머뭅니다. 장애 도메인을 나누지 못한 대가는 여전히 남습니다.
교차 FK를 지우기 전에는 자식 ID의 출처와 부모 삭제 경로를 확인해야 했습니다. 지운 뒤에는 스키마·계정·이력이 갈라졌는지 확인했고, 권한 격리의 핵심 음성 검사는 아직 실행되지 않았습니다. 멱등성 기록의 보존 기간도 처음에는 7일 경계에 여유가 없었습니다. 데이터 소유권을 나누는 결정은 제약을 제거하는 순간 끝나지 않았습니다. 제거한 제약이 맡던 책임과 그 검증 위치까지 옮겨야 했습니다.