malloc(64) 를 부를 때마다 운영체제에 64바이트를 요청한다면, 작은 객체를 자주 만드는 프로그램은 그때마다 시스템 콜 비용을 치르게 됩니다. 실제 할당자는 brk 나 mmap 으로 큰 영역을 미리 받아 두고 그 안을 잘라 요청에 내줍니다. 해제된 블록은 다음 요청에 다시 씁니다. 여러 스레드가 같은 관리 구조를 동시에 고치지 않도록 상태를 나누고 쓰지 않는 페이지는 정책에 따라 운영체제에 돌려줍니다.
이 일을 하는 동안 할당 지연 시간, 메모리 사용량, 스레드가 늘 때의 확장성이 서로 부딪칩니다. 빈 블록을 많이 들고 있으면 할당은 빨라지지만 메모리를 더 씁니다. 운영체제에 빨리 돌려주면 메모리는 줄지만 다음에 페이지를 다시 받아야 합니다. 이 글에서는 glibc malloc, jemalloc, TCMalloc, mimalloc 이 작은 요청을 처리하는 경로를 차례로 따라가고 HotSpot JVM 의 TLAB 이 같은 문제를 어떻게 다르게 푸는지 비교합니다. 출발점은 다음 질문이었습니다.
작은 객체를 할당할 때 할당자는 어디서 빈 메모리를 찾고, 여러 스레드가 동시에 할당하면 경합을 어떻게 줄일까요? Java 의
new는 같은 문제를malloc과 어떻게 다르게 풀까요?
각 할당자의 공식 문서와 소스 코드를 바탕으로 정리했습니다. 직접 실행한 벤치마크나 측정 결과는 포함하지 않았습니다. 구현 설명은 자주 지나가는 경로를 단순화한 것이라 버전, 설정, 요청 크기, 플랫폼에 따라 실제 동작이 달라질 수 있습니다.
1. 할당자 안의 단위는 어떻게 나뉠까요?
네 할당자는 비슷한 이름을 서로 다른 계층에 씁니다. 이 글에서는 아래 뜻으로 씁니다.
| 용어 | 뜻 | 헷갈리기 쉬운 점 |
|---|---|---|
| chunk, block | 할당 하나 또는 빈 공간 하나를 나타내는 블록 | 요청 하나에 내주는 단위입니다. |
| free list | 빈 블록을 서로 이어 둔 목록 | 빈 블록 안에 다음 빈 블록의 주소를 적어 이어 둡니다. |
| arena | 메모리 영역과 그 영역의 할당, 해제 상태를 묶은 관리 단위 | 빈 메모리를 모아 둔 캐시와 다릅니다. lock 과 bin 같은 관리 상태를 함께 가집니다. |
| thread cache (tcache) | 스레드가 곧바로 다시 쓸 빈 블록을 보관하는 캐시 | 공유 관리 구조에 접근하는 횟수를 줄입니다. |
| size class | 요청 크기를 몇 가지 규격으로 나눈 등급 | 빈 블록을 찾기 쉬워지지만 올림한 만큼 공간이 남습니다. |
| bin | 한 size class 의 빈 블록이나 slab 을 관리하는 구조 | 할당자마다 내부 구조가 다릅니다. |
| slab, page | 같은 크기 객체 여러 개를 배치하는 영역. 객체 하나가 놓이는 자리를 slot 또는 region 이라고 부릅니다 | 빈 slot 이 있어도 살아 있는 객체가 하나라도 남으면 통째로 회수하기 어렵습니다. |
| extent, span | 더 큰 연속 가상 메모리 영역을 관리하는 단위 | 작은 객체용 slab 의 바탕이 되거나 큰 할당을 직접 처리합니다. |
arena 는 관리 주체이고 chunk 는 arena 가 관리하는 블록이며 tcache 는 arena 앞에 놓인 빠른 재사용 경로입니다. arena 하나가 여러 스레드의 요청을 처리할 수 있고 arena 가 관리하는 영역에는 사용 중인 블록과 빈 블록이 섞여 있습니다.
이 글은 표기도 나눠 씁니다. 영어 page 는 mimalloc 의 page 처럼 할당자가 정한 관리 단위이고, 한글 페이지는 운영체제가 메모리를 관리하는 단위(보통 4KiB)입니다.
객체를 해제하는 일과 페이지를 운영체제에 돌려주는 일도 따로 일어납니다. free 로 돌아온 블록은 할당자가 다음 요청에 쓰려고 계속 들고 있을 수 있습니다. 운영체제가 물리 페이지를 돌려받으려면 페이지가 통째로 비어 있고 할당자가 그 페이지를 반환해야 합니다. 블록을 흩어서 해제할 때와 몰아서 해제할 때 RSS 가 어떻게 달라지는지는 Java 힙은 여유로운데 컨테이너는 왜 종료될까? 에서 직접 해제해 보는 예제로 다뤘습니다.
2. glibc malloc 은 빈 공간을 어디서 찾을까요?
glibc 기반 Linux 배포판의 C 프로그램이 기본으로 쓰는 glibc malloc 은 chunk 단위로 메모리를 관리합니다. chunk 앞쪽에는 크기와 몇 가지 플래그 같은 관리 정보가 있고 malloc 이 돌려주는 주소는 그 뒤의 데이터 영역을 가리킵니다. 참고: glibc MallocInternals.
작은 요청은 대략 다음 순서로 처리됩니다. 실제 bin 탐색 순서와 적용 범위는 glibc 버전마다 다릅니다.
glibc malloc 의 요청은 어디까지 내려갈까요?
malloc(64) 하나가 tcache, arena, 운영체제 순서로 내려갑니다. 요청이 어디서 해결되는지 골라 보내 보세요.
glibc 의 작은 요청 경로를 단순화한 모형입니다. arena 안에서 bin 을 찾는 순서, chunk 분할, mmap_threshold 보다 큰 요청의 경로는 한 층으로 묶었습니다. lock 을 언제 놓는지는 그리지 않았습니다. 수치는 이 요청 하나의 경로에서 센 값이며 측정값이 아닙니다.
tcache 는 glibc 2.26 부터 들어간 스레드별 캐시입니다. 스레드마다 크기별로 chunk 몇 개를 들고 있어서 같은 스레드가 해제한 chunk 를 arena 의 lock 없이 다시 내줄 수 있습니다. tcache 는 64비트에서 기본 1032바이트 이하 요청에만 쓰이고 이 크기의 요청은 tcache 가 비어 있을 때만 arena 로 내려갑니다.
arena 를 늘리면 무엇이 달라질까요?
arena 는 lock, bin, heap 상태를 가진 관리 단위이고 그 아래에 여러 chunk 가 있습니다. 처음에는 main arena 하나로 시작합니다. 스레드는 처음 할당할 때 arena 를 배정받습니다. 상한에 이르기 전에는 새 arena 를 만들고 상한에 이르면 기존 arena 를 다른 스레드와 함께 씁니다. arena 수의 상한은 GLIBC_TUNABLES=glibc.malloc.arena_max=2 처럼 환경 변수로 지정합니다. 따로 정하지 않으면 glibc 소스(malloc.c 의 NARENAS_FROM_NCORES)가 64비트 시스템의 상한을 CPU 코어 수의 8배로 계산합니다.
arena 를 늘리면 무엇을 얻고 무엇을 잃을까요?
두 스레드가 동시에 malloc(256) 을 부릅니다. arena 수를 고르면 같은 요청을 다시 보내고, lock 을 기다린 횟수와 새로 받은 공간을 셉니다.
- 사용 중인 chunk
- 해제되어 bin 에 있는 chunk
glibc 의 arena 를 단순화한 모형입니다. 두 스레드의 tcache 는 가득 차 있어서, 해제된 256B chunk 가 tcache 대신 arena 의 bin 으로 갔다고 가정했습니다. bin 탐색과 chunk 분할은 그리지 않았고, heap 확장량은 요청 크기로 단순화했습니다. 실제 heap 은 페이지 단위로 늘어납니다. arena B 를 쓰는 스레드는 arena A 를 확인하러 가지 않습니다. 벽에 튕기는 장면은 탐색 범위가 자기 arena 안으로 한정된다는 뜻으로 그렸습니다. 수치는 이 순서의 요청에서 나온 값이며 측정값이 아닙니다.
arena 를 나눠 lock 경합을 줄이면 빈 chunk 도 arena 마다 흩어집니다. arena A 에 다시 쓸 수 있는 256바이트 chunk 가 많이 남아 있어도, arena B 를 쓰는 스레드는 그 chunk 를 가져다 쓰지 않습니다. 스레드는 자기에게 배정된 arena 의 bin 만 찾고 다른 arena 는 공간을 늘리지 못해 할당이 실패할 때에만 시도합니다.
bin 은 왜 여러 종류일까요?
glibc 는 크기와 상태에 따라 빈 chunk 를 여러 bin 에 나눠 둡니다. glibc 2.42 까지의 구조에는 작은 chunk 를 이웃한 빈 chunk 와 병합하지 않고 빠르게 다시 쓰는 fastbin, 한 크기의 chunk 만 담는 smallbin, 크기 범위로 묶는 largebin, 해제된 chunk 를 잠시 두었다가 다음 탐색 때 정리하는 unsorted bin 이 있습니다. 빠른 재사용과 병합을 미루는 일처럼 bin 마다 목적이 다릅니다. glibc 2.43 에서는 fastbin 이 빠졌습니다. 이처럼 bin 구성은 버전에 따라 바뀌므로 구현을 분석할 때는 해당 버전의 소스를 읽어야 합니다.
큰 요청은 다른 경로를 탑니다. mmap_threshold 보다 큰 요청은 heap 을 늘리는 대신 mmap 으로 따로 받고 해제하면 바로 munmap 으로 돌려줍니다. mmap_threshold 의 기본값은 128KiB 에서 시작해 mmap 으로 받은 chunk 가 해제될 때 그 크기만큼 올라가는 식으로 동적으로 바뀝니다. heap 맨 위(top chunk)의 빈 공간이 trim_threshold 를 넘으면 그 부분을 운영체제에 반환합니다.
arena_max, tcache_count, trim_threshold, mmap_threshold 같은 조절 항목은 앞에서 본 arena, tcache, heap 반환 동작을 바꿉니다. tcache_count 는 tcache 가 크기별로 보관할 chunk 수입니다. tcache 에 chunk 를 넉넉히 두면 재사용이 빨라집니다. 다만 프로세스가 들고 있는 메모리가 늘 수 있습니다. 참고: GNU C Library: Memory Allocation Tunables.
3. jemalloc 은 같은 크기 객체를 어떻게 모을까요?
jemalloc 은 작은 요청을 size class 로 올림하고 같은 size class 의 객체를 slab 에 빽빽하게 모아 둡니다. 크기별로 공간이 나뉘어 있어 재사용이 빠르고 크기마다 얼마나 쓰는지 예측하기도 쉽습니다.
jemalloc 의 요청은 어디까지 내려갈까요?
malloc(64) 하나가 size class 를 정한 뒤 tcache, arena 의 bin 과 slab, 새 extent 순서로 내려갑니다. 요청이 어디서 해결되는지 골라 보내 보세요.
jemalloc 의 작은 요청 경로를 단순화한 모형입니다. tcache 를 다시 채우는 묶음 이동, decay 로 보관 중인 페이지의 재사용은 그리지 않았습니다. lock 을 언제 놓는지는 그리지 않았습니다. 수치는 이 요청 하나의 경로에서 센 값이며 측정값이 아닙니다.
arena 안의 구조를 계층으로 그리면 다음과 같습니다.
- region: slab 안의 객체 slot 하나입니다.
- slab: 한 size class 의 region 여러 개를 담는 영역입니다.
- bin: 한 size class 의 slab 과 할당을 관리합니다.
- extent: slab 의 바탕이 되거나 큰 할당에 쓰이는 연속 메모리 영역입니다.
slab 안의 빈 region 은 bitmap 으로 추적합니다. tcache 에 객체가 남아 있으면 malloc 은 slab 의 bitmap 을 보지 않고 tcache 에서 바로 객체를 내줍니다. jemalloc 도 arena 를 여러 개 두고 스레드를 나눠 배정합니다. 기본 arena 수는 CPU 수의 4배입니다. 참고: jemalloc(3).
size class 를 촘촘하게 나누면 메모리가 줄어들까요?
size class 가 64B 와 128B 뿐이라면 65B 요청은 128B slot 에 들어가고 63B 가 남습니다. jemalloc 의 기본 size class 처럼 64B 와 128B 사이에 80B, 96B, 112B 가 있으면 65B 요청은 80B slot 에 들어가고 15B 만 남습니다.
size class 가 촘촘할수록 slot 안에서 남는 공간은 줄어듭니다. 대신 관리할 bin 이 늘고 size class 마다 slab 을 따로 두므로 덜 찬 slab 이 여러 size class 에 흩어질 수 있습니다. 그래서 size class 를 촘촘하게 만들어도 전체 메모리 사용량이 항상 줄지는 않습니다.
slab 에 객체 하나만 남으면 어떻게 될까요?
64B region 64개를 담은 4KiB slab 을 단순하게 가정해 보겠습니다. region 63개가 비고 하나만 살아 있다면, 빈 region 63개는 다음 64B 요청에 다시 쓸 수 있습니다. 하지만 살아 있는 객체를 옮길 수 없는 native 할당자는 이 slab 전체를 다른 용도로 돌리거나 운영체제에 반환할 수 없습니다. 객체를 옮기면 그 객체를 가리키는 포인터가 모두 틀어지기 때문입니다.
프로그램이 이 slab 의 객체를 모두 free 했더라도 그중 tcache 에 들어간 객체는 아직 slab 으로 돌아오지 않았습니다. slab 쪽에서 보면 tcache 가 들고 있는 객체도 할당된 객체라서 tcache 가 비워져 이 객체들까지 돌아와야 slab 전체를 반환할 수 있습니다.
빈 페이지는 언제 운영체제로 돌아갈까요?
slab 이나 extent 가 비자마자 운영체제에 돌려주면, 다음에 요청이 몰릴 때 페이지를 다시 받아야 합니다. jemalloc 은 빈 페이지를 일정 시간 들고 있다가 정리하는 decay 정책을 씁니다. 쓰지 않지만 내용이 남아 있는 페이지를 dirty 라고 부릅니다. 커널이 필요할 때 가져갈 수 있게 madvise(MADV_FREE) 등으로 표시해 둔 페이지는 muzzy 라고 부릅니다. 정리는 dirty 페이지를 muzzy 로 바꾸고, muzzy 페이지를 운영체제에 완전히 돌려주는 두 단계로 진행됩니다. dirty_decay_ms 와 muzzy_decay_ms 는 각 단계의 페이지를 얼마 동안에 걸쳐 정리할지 정합니다. 기본 설정에서 dirty_decay_ms 는 10초이고 muzzy_decay_ms 는 0이라 muzzy 단계는 꺼져 있습니다.
dirty_decay_ms=0 은 쓰지 않는 dirty 페이지가 생기는 즉시 정리하라는 설정입니다. 사용 중인 객체에는 영향이 없습니다. 객체 하나가 살아 있는 slab 의 페이지는 이 값을 0으로 두어도 반환되지 않습니다.
4. TCMalloc 은 왜 스레드 대신 CPU 마다 캐시를 둘까요?
TCMalloc 은 Google 이 만든 할당자로, 요청이 front-end, middle-end, back-end 를 차례로 거칩니다.
TCMalloc 의 요청은 어디까지 내려갈까요?
malloc(64) 하나가 front-end, middle-end, back-end, 운영체제 순서로 내려갑니다. 요청이 어디서 해결되는지 골라 보내 보세요.
TCMalloc 의 요청 경로를 단순화한 모형입니다. front-end 는 per-CPU 모드로 그렸고, middle-end 가 front-end 를 객체 묶음으로 채우는 동작은 한 번의 응답으로 줄였습니다. lock 을 언제 놓는지는 그리지 않았습니다. 수치는 이 요청 하나의 경로에서 센 값이며 측정값이 아닙니다.
front-end 는 lock 없이 객체를 내주는 캐시입니다. middle-end 는 front-end 가 비었을 때 객체를 묶음으로 채워 주고 front-end 에 넘치는 객체를 받아 갑니다. transfer cache 는 객체 묶음을 front-end 사이에서 빠르게 주고받는 곳이고 central free list 는 span 에서 객체를 꺼내 나눠 주는 곳입니다. back-end 의 pageheap 은 연속 페이지 묶음인 span 을 관리하고 운영체제에서 메모리를 받아 오거나 돌려줍니다. 참고: TCMalloc Design.
캐시를 CPU 에 붙이면 무엇이 줄어들까요?
per-thread 캐시는 스레드마다 다시 쓸 블록을 보관합니다. gperftools 에 들어 있는 예전 TCMalloc 이 이 방식을 씁니다. 캐시 수가 스레드 수를 따라 늘어나는 구조입니다.
스레드가 늘면 캐시도 늘어날까요?
논리 CPU 8개 위에서 스레드가 실행됩니다. 스레드 수를 끌어 보고, 캐시를 스레드에 붙이는 방식과 CPU 에 붙이는 방식을 바꿔 보세요.
- 스레드
- 캐시 하나 (상한 1MiB 가정)
캐시 하나의 상한을 1MiB 로 같게 둔 설명용 모형이고, TCMalloc 의 실제 메모리 사용량을 예측한 값이 아닙니다. 실제 per-thread 캐시에는 스레드 캐시 전체의 합계 상한이 따로 있고, per-CPU 캐시의 크기도 부하에 따라 조정됩니다. 스레드는 CPU 에 번갈아 배정되는 것으로 그렸습니다.
위 장면은 캐시 하나의 상한을 1MiB 로 같게 둔 설명용 가정입니다. 스레드 200개가 각자 캐시를 두면 상한의 합은 200MiB 이고 논리 CPU 8개에 캐시를 하나씩 두면 합은 8MiB 입니다. 실제 TCMalloc 의 메모리 사용량을 예측한 값은 아닙니다. 실제 per-thread 캐시 전체에는 합계 상한이 있어서 스레드가 많아지면 스레드마다 쓸 수 있는 캐시가 작아지고 middle-end 에 내려가는 일이 잦아집니다. 스레드별 최소 크기가 있어서 합계가 상한을 넘기도 합니다. 참고: TCMalloc Design.
per-CPU 모드에서는 캐시가 스레드 대신 논리 CPU 에 붙어서 캐시 수가 스레드 수와 상관없이 CPU 수로 정해집니다.
한 CPU 의 캐시를 여러 스레드가 써도 안전할까요?
CPU 하나에서도 여러 스레드가 번갈아 실행됩니다. Thread A 가 free list 의 head 포인터를 읽은 직후 preemption 으로 밀려나고 Thread B 가 같은 CPU 에서 실행될 수 있습니다. 평범한 포인터 쓰기만으로 free list 를 고치면 같은 블록을 두 번 내주거나 목록 갱신 하나를 잃어버릴 수 있습니다.
Linux 에서 TCMalloc 의 per-CPU 경로는 rseq(Restartable Sequences)를 씁니다. 짧은 CPU 로컬 연산을 rseq 구간으로 등록해 두면, 그 구간을 실행하던 스레드가 preemption 되거나 다른 CPU 로 옮겨지거나 시그널을 받을 때 커널이 구간을 중단하고 프로그램이 등록해 둔 abort 위치로 실행을 옮깁니다. 같은 CPU 에 머무는 흔한 경우에는 원자적 연산 없이 캐시를 고치고, 드물게 중단될 때만 다시 실행하는 방식입니다. rseq 가 모든 쓰기를 원자적으로 만들어 주지는 않습니다. TCMalloc 은 구간 마지막의 쓰기 한 번으로 결과를 확정하고 그 전에 중단되면 처음부터 다시 실행해도 안전하도록 자료구조를 설계합니다. rseq 를 쓸 수 없는 환경에서는 per-thread 모드로 동작합니다. 참고: TCMalloc rseq.
per-CPU 캐시로 경합이 모두 사라질까요?
front-end 에서 끝나는 요청은 빠르지만 캐시가 비면 central free list 같은 중앙 계층으로 내려갑니다. 여기서는 동기화와 객체를 옮기는 비용이 듭니다. 캐시를 크게 잡으면 중앙 계층에 내려가는 횟수가 줄고 CPU 마다 들고 있는 메모리는 늘어납니다. 작게 잡으면 그 반대가 됩니다. TCMalloc 은 per-thread, per-CPU 모드 모두 부하를 보고 캐시 크기를 늘리거나 줄입니다.
5. mimalloc 은 다른 스레드가 해제한 블록을 어떻게 받을까요?
mimalloc 은 free list 를 page 마다 나눠 둡니다. 크기별로 큰 목록 하나를 공유하는 대신, 한 size class 의 블록을 담는 작은 page 여러 개가 각자 빈 블록 목록을 관리합니다. 논문에서는 이를 free list sharding 이라고 부릅니다. 참고: Mimalloc: Free List Sharding in Action.
가까운 시점에 할당한 객체가 같은 page 에 모이므로 메모리 지역성이 좋아지고 관리 구조도 page 단위로 나뉩니다. mimalloc 의 page 는 운영체제의 4KiB 페이지와 다른 단위이고 대개 그보다 큽니다. 스레드마다 자기 heap 을 두고 page 는 그 page 를 할당한 스레드가 소유합니다.
다른 스레드가 해제하면 무엇이 문제일까요?
Thread A 가 할당한 블록을 Thread B 가 해제하는 경우를 cross-thread free 라고 부릅니다.
mimalloc 의 page 는 용도가 다른 목록 세 개를 가집니다.
| 목록 | 용도 |
|---|---|
free | 소유 스레드가 할당할 때 쓰는 빈 블록 |
local_free | 소유 스레드가 해제한 블록을 모아 두는 목록 |
thread_free | 다른 스레드가 해제한 블록을 원자적 연산으로 모아 두는 목록 |
다른 스레드가 해제한 블록은 언제 다시 쓰일까요?
Thread A 가 소유한 page 에 목록이 세 개 있습니다. 버튼을 눌러 할당하고 해제하면서 블록이 어느 목록으로 가는지 따라가 보세요.
- 사용 중인 블록
- 빈 블록 (목록에 있음)
mimalloc 의 page 하나만 그린 단순화 모형입니다. B 가 해제하는 블록은 A 가 할당해 B 에게 넘겨준 블록이라고 가정했습니다. 블록이 모두 쓰일 때 다른 page 를 찾거나 새 page 를 받는 경로, page 가 가득 찼을 때 다른 스레드의 해제가 heap 의 delayed free 목록으로 가는 경로, 메모리 순서와 노드 수명 같은 동기화 세부는 그리지 않았습니다.
소유 스레드의 free 목록은 원자적 연산 없이 고칩니다. 다른 스레드가 이 목록을 직접 고치면 소유 스레드의 갱신과 경쟁하게 됩니다. 그래서 Thread B 는 thread_free 에 블록을 넣습니다. 이 목록은 CAS(Compare-And-Swap)로 갱신해 여러 스레드가 동시에 넣어도 갱신을 잃지 않습니다. 소유 스레드는 free 목록이 비었을 때 느린 경로로 내려갑니다. 이때 thread_free 는 원자적 교환 한 번으로 목록 전체를 가져와 local_free 와 함께 free 로 옮깁니다.
소유 스레드가 해제한 블록을 free 에 바로 돌려놓지 않고 local_free 에 모으는 이유도 이 느린 경로에 있습니다. free 는 할당할수록 줄어들기만 하므로 일정 횟수 할당하면 반드시 비고 그때마다 느린 경로가 돌아 미뤄 둔 정리 작업을 처리합니다. mimalloc 은 이를 heartbeat 라고 부릅니다. 참고: mimalloc types.h.
// 개념 설명을 위한 단순화된 Lock-free push
// 실제 구현에서는 메모리 순서, 노드 수명, ABA 등도 고려한다.
do {
    old_head = atomic_load(&head);
    node->next = old_head;
} while (!CAS(&head, old_head, node));
위 코드에서 CAS 가 성공했다면 그 순간 head 가 old_head 와 같았다는 것까지만 보장됩니다. 그 사이에 값이 A 에서 B 로 바뀌었다가 다시 A 로 돌아온 경우(ABA 문제)는 CAS 만으로 구별할 수 없어서 실제 구현은 메모리 순서와 노드 수명까지 따집니다.
6. 네 할당자를 나란히 놓으면 무엇이 다를까요?
| 비교 기준 | glibc malloc | jemalloc | TCMalloc | mimalloc |
|---|---|---|---|---|
| 작은 객체의 빠른 경로 | tcache | tcache | per-CPU 또는 per-thread front-end | 스레드별 heap 의 page free list |
| 블록 관리 단위 | chunk, bin | size class, slab, region | size class, span, pageheap | size class, page, block |
| 공유 관리 구조 | arena | arena | central free list, transfer cache | 다른 스레드가 블록을 넣는 thread_free |
| 경합을 줄이는 방법 | 여러 arena 와 tcache | 여러 arena 와 tcache | per-CPU 캐시와 rseq | free list sharding, 다른 스레드의 해제를 별도 목록으로 받기 |
| 빈 메모리 반환 | heap 맨 위 trim, mmap 영역 해제 | extent 와 decay | back-end 가 운영체제에 반환 | 이 글에서 다루지 않음 |
어느 할당자가 가장 빠른지는 구조만 보고 답할 수 없습니다. 스레드 수, 요청 크기 분포, 객체 수명, cross-thread free 비율, 메모리 한도, 운영체제 설정에 따라 결과가 달라집니다.
네 할당자 모두 같은 비용을 서로 다른 곳에서 치릅니다. 빈 블록을 많이 보관해 재사용을 빠르게 하면 메모리 점유량이 늘 수 있습니다. 반대로 메모리를 적극적으로 운영체제에 반환하면 나중에 페이지를 다시 받는 비용이 늘 수 있습니다. 할당자를 고르거나 설정을 바꿀 때는 이 비용을 언제, 어느 계층에서 치를지 정하게 됩니다.
7. Java 의 new 는 malloc 과 무엇이 다를까요?
Java 에서도 객체를 만들면 메모리 공간이 필요합니다.
Member member = new Member();다만 일반적인 Java 객체는 개발자가 free() 를 부르지 않습니다. new 가 객체 공간을 할당하고 GC 가 어떤 객체를 회수할지 정해 공간을 되찾습니다.
TLAB 은 tcache 와 같은 것일까요?
HotSpot JVM 의 TLAB(Thread Local Allocation Buffer)은 스레드 전용 객체 할당 영역입니다. 이름은 tcache 와 비슷하지만 하는 일이 다릅니다.
| native 할당자의 tcache | HotSpot 의 TLAB |
|---|---|
| 해제된 블록을 보관했다가 다시 내줌 | 새 객체를 이어 붙여 배치할 연속 공간을 확보 |
| size class 별로 빈 블록을 관리 | bump pointer 로 할당 |
malloc, free 와 연결 | new 와 GC 가 관리하는 Java 힙에 연결 |
두 구조 모두 공유 할당 상태에 매번 접근하지 않게 해서 동기화 비용을 줄입니다.
TLAB 안에서는 어떻게 할당할까요?
새 객체의 크기가 size 라면, 남은 공간이 충분한지 검사하고 top 을 그만큼 앞으로 옮깁니다.
if (size <= end - top):
    address = top
    top += size
    객체 초기화
    return address
else:
    TLAB Slow Path
핵심만 추린 의사 코드입니다. 실제 JVM 은 정렬, 객체 헤더 기록, 필드 초기화 같은 일을 함께 합니다. HotSpot 소스의 ThreadLocalAllocBuffer 에는 _start, _top, _end 와 TLAB 을 다시 받을 때 쓰는 상태가 있습니다. 참고: threadLocalAllocBuffer.hpp.
공유 영역에는 언제 접근할까요?
Thread 1 이 자기 TLAB 에 객체를 만듭니다. 작은 객체와 큰 객체를 여러 번 만들면서 공유 영역 접근 수가 언제 늘어나는지 세어 보세요.
- 객체
- filler (버린 TLAB 의 남은 공간)
- 다른 스레드의 TLAB
HotSpot 의 TLAB 할당을 단순화한 모형입니다. 크기는 TLAB 을 20으로 둔 상대 단위이고, 남은 공간이 4보다 크면 TLAB 을 유지한다고 가정했습니다. 실제 기준값과 TLAB 크기는 할당 통계에 따라 조정됩니다. 객체 헤더, 정렬, 필드 초기화와 GC 는 그리지 않았습니다. eden 은 G1 처럼 region 으로 나뉠 수 있지만 한 막대로 그렸습니다. eden 접근은 빠른 경우의 원자적 연산만 그렸고, region 이 바닥나 lock 을 잡는 경로와 아주 큰 객체(humongous)를 별도 영역에 두는 경로는 생략했습니다.
이 경로에서는 free list 를 따라가며 맞는 빈 블록을 찾지 않습니다. 자기 TLAB 안에서 포인터 하나를 옮기면 할당이 끝나고 다른 스레드와 공유하는 상태도 건드리지 않습니다. eden 은 Java 힙에서 새 객체가 처음 놓이는 영역이고 여러 스레드가 함께 씁니다. 스레드는 TLAB 을 새로 받거나 객체를 TLAB 밖에 할당할 때만 이 영역에 접근하고 빠른 경우에는 lock 대신 원자적 연산을 씁니다.
TLAB 이 부족하면 어떻게 될까요?
TLAB 에 남은 공간으로 새 객체를 담을 수 없으면 JVM 은 상황에 따라 다음 가운데 하나를 고릅니다.
- 남은 공간이 작으면 지금 TLAB 을 버리고 새 TLAB 을 받습니다. 버린 TLAB 의 남은 공간은 filler 라는 빈 객체로 채워 힙을 순서대로 읽을 수 있게 둡니다.
- 남은 공간이 아직 크면 TLAB 은 그대로 두고 이번 객체만 TLAB 밖의 공유 영역에 할당합니다.
- 힙에 여유가 없으면 GC 를 실행합니다.
버린 TLAB 의 남은 공간은 다음 GC 까지 쓰이지 않습니다. HotSpot 의 세대별 GC 는 young GC 때 eden 의 살아 있는 객체를 다른 영역으로 옮겨 eden 을 다시 비우고 새 TLAB 은 그렇게 빈 공간에서 다시 잘려 나옵니다. 이 낭비와 공유 영역에 자주 내려가는 비용 사이에서 HotSpot 은 할당 통계를 보고 스레드별 TLAB 크기를 조정합니다. 참고: threadLocalAllocBuffer.cpp.
어느 경우든 new 를 부를 때마다 운영체제에 메모리를 요청하지는 않습니다. HotSpot 은 미리 확보해 둔 Java 힙 안에서 할당을 처리합니다.
메서드가 끝나면 top 을 되돌릴까요?
지역 변수는 메서드가 끝나면 스택에서 사라지므로, TLAB 의 top 도 그때 되돌릴 수 있을 것처럼 보입니다.
void process() {
    Member a = new Member();
    Member b = new Member();
}
process() 가 끝나도 두 객체의 수명이 반드시 끝나지는 않습니다. 참조가 다른 곳으로 전달되었을 수 있습니다. 객체가 살아 있는지는 GC root(스택의 지역 변수, static 필드 등)에서 참조를 따라 그 객체에 도달할 수 있는지로 정해집니다.
TLAB 은 새 객체를 배치하는 도구이고 객체가 죽었는지는 알지 못합니다. 그래서 메서드가 끝날 때마다 TLAB 의 top 을 되돌리지 않습니다. GC 는 어떤 객체를 회수할지 정하고 회수한 공간을 다시 쓸 수 있게 만듭니다.
JIT 컴파일러는 예외적인 최적화를 할 수 있습니다. escape analysis 로 객체가 메서드 밖으로 나가지 않는다고 확인되면, HotSpot 의 C2 컴파일러는 할당을 없애고 필드를 지역 변수처럼 다루는 scalar replacement 를 적용할 수 있습니다. 그래서 코드에 new 가 있어도 실제 힙 객체가 반드시 만들어지지는 않습니다.
8. native 할당자와 TLAB 은 어디까지 닮았을까요?
native 할당자와 TLAB 은 모두 자주 일어나는 작은 할당을 빠르게 처리하고 공유 상태의 동기화 비용을 줄이려고 만든 구조입니다. 두 구조는 객체가 끝나는 시점을 누가 정하는지부터 다릅니다.
| 기준 | native 할당자 (malloc 계열) | HotSpot JVM 의 일반 객체 할당 |
|---|---|---|
| 객체를 다 썼다고 알리는 쪽 | 프로그램이 free() 를 호출 | GC 가 도달 가능성을 보고 회수 대상을 정함 |
| 빠른 할당 방식 | tcache, size class, free list | TLAB 의 bump pointer |
| 살아 있는 객체 이동 | 기존 포인터 때문에 옮길 수 없음 | 이동하는 GC 는 참조를 갱신하며 옮길 수 있음 |
| 회수를 막는 요인 | 흩어진 빈 블록, 살아 있는 객체가 남은 slab 과 page | GC 정책, 살아 있는 객체 비율, 힙 구조 |
| 주로 보는 지표 | RSS, 경합, 단편화, 페이지 반환 | 할당률, GC 오버헤드, TLAB 낭비, 힙 압력 |
native 할당자는 3장의 slab 처럼 객체 하나 때문에 영역 전체를 회수하지 못할 수 있습니다. 이동하는 GC 는 살아 있는 객체를 한쪽으로 모아 남은 공간을 다시 연속 공간으로 만들 수 있습니다. 그 연속 공간 덕분에 TLAB 이 bump pointer 로 할당할 수 있습니다.
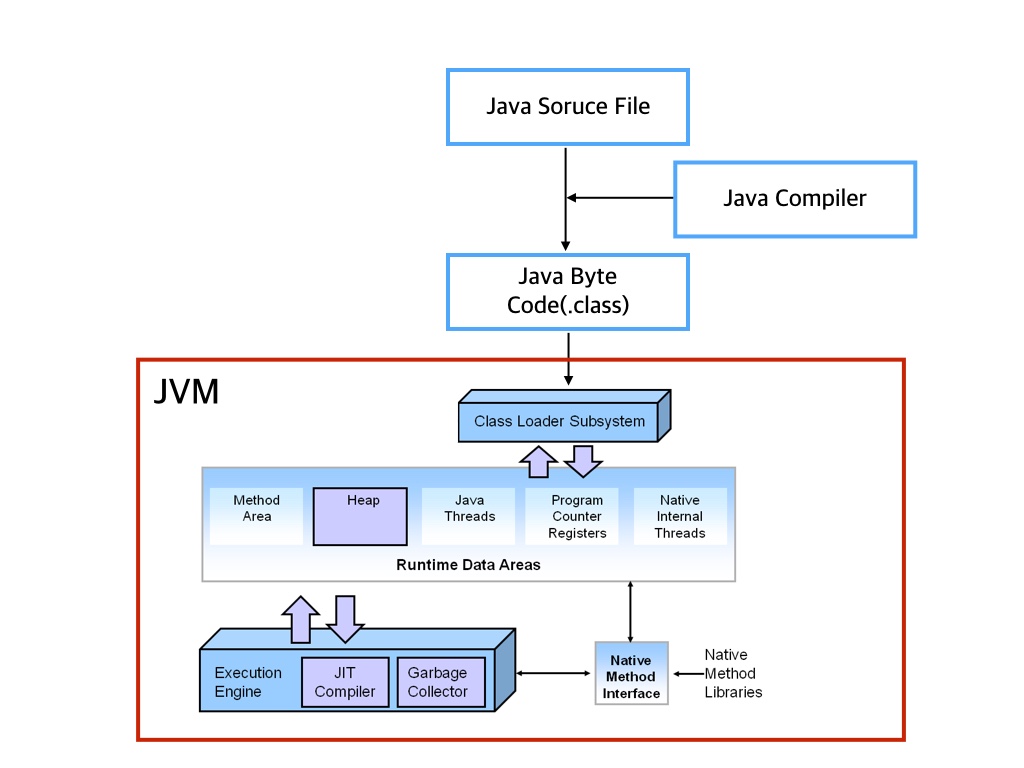
이 표는 Java 힙의 일반 객체 할당만 다룹니다. JVM 프로세스의 모든 메모리를 TLAB 과 GC 가 관리하지는 않습니다. direct buffer, JNI 코드, JVM 내부 자료구조 일부는 malloc 으로 할당되고 이 할당에는 2장부터 6장까지의 할당자 동작이 적용됩니다. Metaspace, 스레드 스택, Java 힙 자체처럼 mmap 으로 직접 받는 영역도 있습니다.
9. RSS 가 높을 때는 무엇부터 나눠 봐야 할까요?
서버 프로세스의 RSS 가 높다고 곧바로 메모리 누수로 볼 수는 없습니다. 애플리케이션이 해제한 블록을 할당자가 다시 쓰려고 들고 있을 수도 있습니다. 메모리 문제를 조사할 때는 다음 질문을 나눠서 답해 볼 수 있습니다.
- 살아 있는 할당량이 계속 늘어나는가? 해제되지 않는 객체가 쌓이는지 봅니다.
- 해제한 뒤에도 RSS 가 그대로인가? 할당자 캐시, arena, 일부만 쓰는 slab, 페이지 반환 정책을 의심해 볼 수 있습니다.
- 작은 할당이 매우 잦은가? 빠른 경로의 hit rate 와 중앙 관리 구조의 경합을 봅니다.
- 다른 스레드에서 해제하는 경우가 많은가? 객체를 만든 스레드와 해제하는 스레드가 다르면 cross-thread free 경로의 비용이 드러날 수 있습니다.
- Java 서비스인가? Java 힙 사용량과 GC 지표, 프로세스 전체 RSS, native 메모리를 따로 봅니다.
할당자를 직접 비교한다면 할당 처리량, p95 와 p99 지연 시간, RSS, 페이지 폴트 수, 스레드 수, 객체 크기와 수명 분포를 같은 부하에서 함께 기록해야 결과를 해석할 수 있습니다. 비교 결과는 할당 패턴과 정책별 비용으로 정리해 두어야 다른 서비스에도 가져다 쓸 수 있습니다.
10. 처음 질문으로 돌아가면
작은 객체를 할당할 때 할당자는 어디서 빈 메모리를 찾고, 여러 스레드가 동시에 할당하면 경합을 어떻게 줄일까요? Java 의
new는 같은 문제를malloc과 어떻게 다르게 풀까요?
| 대상 | 빈 메모리를 찾는 곳 | 경합을 줄이는 방법 | 빈 메모리를 돌려주는 방식 |
|---|---|---|---|
| glibc malloc | tcache, 이어서 arena 의 bin | 여러 arena 와 tcache | heap 맨 위 trim, mmap 영역 해제 |
| jemalloc | tcache, 이어서 bin 의 slab | 여러 arena 와 tcache | decay 정책에 따라 extent 의 페이지 정리 |
| TCMalloc | per-CPU 캐시, 이어서 central free list | 캐시를 CPU 에 붙이고 rseq 사용 | back-end 가 운영체제에 반환 |
| mimalloc | 스레드 heap 의 page free list | page 마다 목록을 나누고 다른 스레드의 해제를 별도 목록으로 받음 | 이 글에서 다루지 않음 |
| HotSpot TLAB | 스레드 전용 TLAB 의 top 뒤 공간 | TLAB 을 새로 받거나 TLAB 밖에 할당할 때만 공유 영역에 접근 | GC 가 회수해 힙 안에서 다시 씀 |
네 native 할당자는 빈 블록을 크기별로 보관했다가 다시 내주고 그 보관 구조를 스레드나 CPU, page 단위로 나눠 경합을 줄입니다. TLAB 은 빈 블록을 찾지 않고 연속 공간에서 포인터를 옮겨 객체를 배치합니다. 회수는 GC 에 맡깁니다.
이 글은 문서와 소스를 읽고 구조를 비교한 정리입니다. 어느 할당자가 특정 서비스에 맞는지는 같은 부하에서 9장의 지표를 측정해야 답할 수 있습니다. 그 측정은 아직 하지 않았습니다.
참고 자료:
- GNU C Library: Memory Allocation Tunables
- glibc MallocInternals
- jemalloc(3) 매뉴얼
- TCMalloc Design, GitHub 설계 문서, TCMalloc rseq
- mimalloc GitHub, mimalloc types.h, Mimalloc: Free List Sharding in Action
- OpenJDK threadLocalAllocBuffer.hpp, threadLocalAllocBuffer.cpp
glibc 는 2.42 와 2.43 소스, 나머지는 각 저장소 기본 브랜치의 소스와 문서를 기준으로 정리했습니다. 버전별 세부 동작은 바뀔 수 있습니다.